
Das PDF-Format von Kontoauszügen verständlich erklärt
Aktualisiert · 19 Min. Lesezeit
Kernaussagen
- PDF ist eine Seite-Beschreibungssprache, nicht ein Datenformat — es enthält Anweisungen zum Zeichnen von Text an bestimmten Koordinaten, nicht Zeilen und Spalten.
- PDF-Kontoauszüge haben keine Tabellensemantik: Der "Tisch", den Sie sehen, ist eine visuelle Illusion, die durch ausgerichteten Text und gezeichnete Linien erzeugt wird.
- Jede Bank generiert PDFs unterschiedlich – Spaltenreihenfolge, Datumsformate, Zahlenformatierung, mehrzeilige Beschreibungen und Seitenumbruch-Handhabung variieren alle.
- Gescannte (Bildbasierte) PDFs fügen eine zusätzliche Schwierigkeitsstufe hinzu: OCR muss Text aus Pixeln rekonstruieren, bevor eine Tabellenanalyse beginnen kann.
- Diese technischen Herausforderungen zu verstehen, erklärt, warum generische "PDF to Excel"-Tools häufig auf Kontoauszügen scheitern und warum zweckgebundene Konverter existieren.
Dieser Artikel ist zu pädagogischen Zwecken. Es ist kein spezifisches technisches Wissen erforderlich, obwohl Leser mit Programmiererfahrung die Codebeispiele besonders informativ finden können.
Funktionsumfang der LocalExtract-Desktop-App: Exportieren Sie jeweils ein ausgewähltes PDF als CSV mit den Spalten
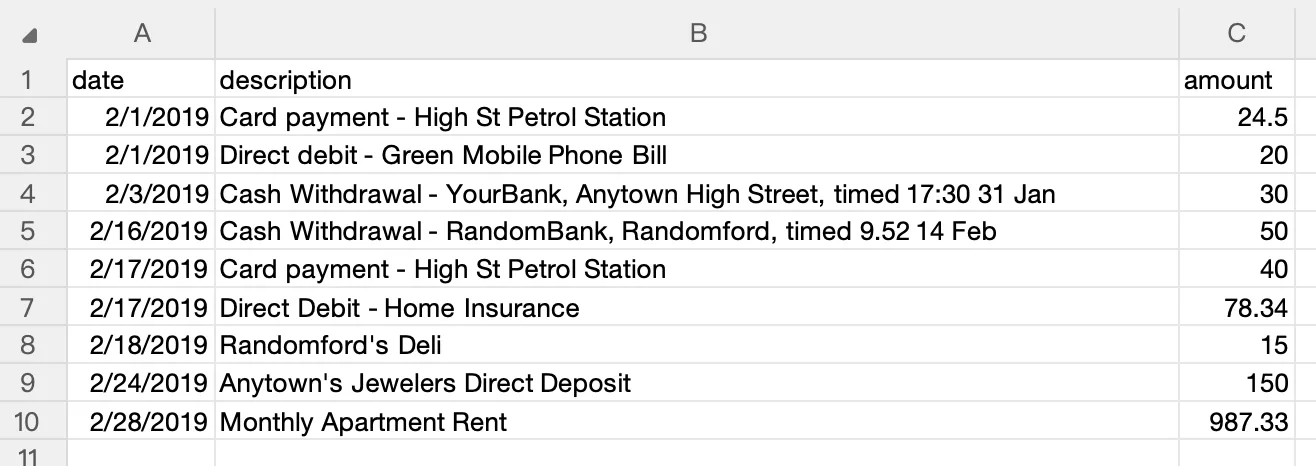
date,descriptionundamount. Öffnen Sie die CSV-Datei in Excel und speichern Sie sie dort bei Bedarf als XLSX. Die App bietet keine Stapelwarteschlange, keinen Export als JSON, QBO oder OFX und keine Synchronisierung mit Buchhaltungssoftware. PDF-Analyse und OCR laufen lokal. Für Konto-, Abonnement- und Aktualisierungsdienste ist eine Internetverbindung erforderlich, einschließlich der regelmäßigen Pro-Verifizierung. Testen Sie Ihren eigenen Kontoauszug und prüfen Sie jede Zeile: Eine unterstützte Sprache oder eine Anleitung zu einer Bank garantiert nicht die Kompatibilität mit jedem Auszugsformat.
Die Desktop-Apps exportieren Datum, Beschreibung und Betrag als CSV. Öffnen Sie die CSV in Excel und speichern Sie dort eine XLSX-Datei. Prüfen Sie das Ergebnis anhand Ihres eigenen PDFs; die Unterstützung hängt vom Auszugsformat ab.
Das grundlegende Problem
Wenn Sie einen PDF-Kontoauszug öffnen und eine übersichtlich formatierte Tabelle von Transaktionen sehen, erkennt Ihr Gehirn mühelos die Struktur. Sie sehen Spalten: Datum, Beschreibung, Betrag, Saldo. Sie sehen Zeilen: eine pro Transaktion. Du siehst einen Tisch.
Transparenzhinweis: Dieser Artikel stammt vom LocalExtract-Team. Wir entwickeln den Desktop-Konverter und haben ein wirtschaftliches Interesse an diesem Thema. Vergleichen Sie die exportierten Zeilen mit Ihrem eigenen Kontoauszug. Bankanleitungen und allgemeine Screenshots sind keine Kompatibilitätsgarantien.
Die PDF-Datei sieht nichts davon. Im PDF gibt es keine Tabelle. Es gibt keine Säulen. Es gibt keine Reihen. Es gibt nur Anweisungen, um einzelne Zeichen und Zeichenketten an bestimmten x,y-Koordinaten auf einer Seite zu platzieren. Die Tabelle ist eine emergente visuelle Eigenschaft — sie existiert im Rendering, nicht in den Daten.
Das ist der Grund, warum das Extrahieren von Daten aus PDF-Kontoauszüge schwierig ist. Jeder Konverter muss die Lücke zwischen dem, was das PDF tatsächlich enthält (positionierte Textfragmente) und was Menschen siehe (strukturierte Transaktionsdaten). Dieser Artikel erklärt genau, was in einem PDF-Kontoauszug ist und warum es die Extraktion herausfordernd macht.
Was ein PDF tatsächlich enthält
Eine PDF-Datei ist um ein paar wichtige Konzepte aufgebaut:
Objekte und Inhaltsströme
Ein PDF besteht aus Objekten – Wörterbücher, Arrays, Strings, Zahlen und Streams. Der visuelle Inhalt jeder Seite lebt in einem Inhalt: eine Abfolge von Operatoren, die beschreiben, was zu zeichnen und wo es zu zeichnen ist.
Hier ist ein vereinfachtes Beispiel, wie ein Content Stream in einem PDF-Kontoauszug aussehen könnte:
BT                          % Begin text block
/F1 10 Tf                   % Set font to F1, size 10pt
72 720 Td                   % Move to position x=72, y=720
(03/15/2026) Tj             % Draw the string "03/15/2026"
180 0 Td                    % Move 180 points to the right
(Direct Deposit - Payroll) Tj  % Draw the description
270 0 Td                    % Move 270 points to the right
(2,500.00) Tj               % Draw the amount
ET                          % End text block
Dies zeichnet drei Zeichenketten auf der Seite. Für einen Menschen, der die gerenderte Seite liest, bilden sie eine Reihe einer Transaktionstabelle. Für einen Computer, der den Inhaltsstrom liest, sind sie drei unabhängige Zeichenfolgen, die an drei verschiedenen horizontalen Positionen auf derselben vertikalen Linie platziert werden.
Koordinatensystem
PDF verwendet ein Koordinatensystem, bei dem (0,0) typischerweise die untere linke Ecke der Seite ist. Die x-Achse verläuft von links nach rechts; die y-Achse läuft von unten nach oben. Eine Standard-US-Letter-Seite ist 612 x 792 Punkte (8,5 x 11 Zoll bei 72 Punkten pro Zoll).
Positionen werden in Fließkommazahlen angegeben, d.h. Text wird nicht an ein Gitter ausgerichtet. Zwei Saiten, die vertikal ausgerichtet erscheinen, können Y-Koordinaten von 720.0 und 719.8 haben — nah genug, um auf der gleichen Linie zu rendern, aber technisch an verschiedenen Positionen. Ein Konverter muss entscheiden, welche Toleranz bei der Gruppierung von Texten in Zeilen zu verwenden ist.
Keine semantische Markierung
HTML hat <table>, <tr>, <td>. PDF hat nichts davon. Die PDF-Spezifikation (ISO 32000) definiert zwar "getaggtes PDF" mit Strukturelementen, aber in der Praxis verwendet PDF fast keine Kontoauszugsform. Die überwiegende Mehrheit der bankgenerierten PDFs sind unvertaggt – der Content-Stream ist die einzige Informationsquelle und enthält nur Zeichnungsanweisungen.
Textpositionierung: Das x,y-Koordinatenproblem
Jedes Stück Text in einem PDF hat eine Position. Das scheint, als ob es die Extraktion einfach machen sollte — lesen Sie einfach den Text und seine Koordinaten, gruppieren Sie sich nach Position und rekonstruieren Sie die Tabelle. In der Praxis treten mehrere Komplikationen auf.
Transformationen der Textmatrix
PDF-Textpositionierung ist nicht einfach "Place String at (x,y)". Die Textposition wird durch eine Kombination der Textmatrix (Tm-Betreiber), Textbewegung und T*) und aktuelle Transformationsmatrix (CTM). Diese können Skalierung, Rotation und Übersetzung umfassen. Ein Konverter muss alle diese Zustandsänderungen verfolgen, um die tatsächliche gerenderte Position jedes Textfragments zu bestimmen.
1 0 0 1 72 720 Tm        % Set text matrix: translate to (72, 720)
(Transaction) Tj          % Draw text at the matrix position
14 0 Td                   % Move right by 14 points for next string
(Date) Tj                 % This appears immediately after "Transaction"
In diesem Beispiel sind "Transaction" und "Date" zwei separate Strings, die zusammen den Header "Transaction Date" bilden. Ein Konverter muss erkennen, dass sie aufgrund ihrer Nähe zusammengeführt werden sollten, aber es gibt keine explizite Angabe im PDF, dass diese beiden Strings ein einziges logisches Element bilden.
Zeichenweise Positionierung
Einige PDF-Generatoren ausgeben Text ein Zeichen zu einer Zeit, mit individuellen Positionierungseinstellungen für Kerning:
[(T) 20 (r) -10 (ansaction)] TJ
Der TJ-Operator nimmt ein Array, in dem Zahlen Kerning-Anpassungen darstellen (in Tausendsteln einer Einheit Textraum). Der Konverter muss diese Zeichenfragmente wieder in lesbare Zeichenketten zusammenbauen, wobei die Positionierungsanpassungen vorgenommen werden müssen, um den Abstand zu bestimmen. Eine große positive Einstellung könnte auf einen Wortbruch hindeuten; eine kleine Anpassung ist einfach nur ein Kerning.
Sub-Pixel-Positionierungsunterschiede
Zwei Reihen einer Tabelle, die perfekt ausgerichtet erscheinen, können aufgrund der Schwebepunktpräzision im PDF-Generator leicht unterschiedliche Y-Koordinaten aufweisen. Zeile 1 kann bei y=540.0 und Zeile 2 bei y=527.2 (eine Zeile nach unten) sein, aber wenn ein dritter String bei y=540.1 ist, ist er Teil von Zeile 1 oder ein separates Element? Um dies zu handhaben, benötigen Konverter toleranzbasierte Gruppierungsalgorithmen.
Fehlende Tabellensemantik
Dies ist die wichtigste technische Herausforderung bei der Extraktion von Kontoauszügen.
Visuelle Tabellen sind keine Datentabellen
Wenn eine Bank ein Statement PDF erzeugt, zeichnet die Rendering-Engine:
- Text-Strings an berechneten Positionen (die den scheinbaren Zellinhalt bilden)
- Linien oder Rechtecke (die die sichtbaren Zellengrenzen bilden)
- Hintergrundfüllungen (erzeugt abwechselnde Zeilenabschattungen)
Keines dieser Elemente ist semantisch verbunden. Die Zeile bei y=530 ist nicht mit dem Text bei y=540 assoziiert. Das schattierte Rechteck ist keine "Zeile" - es ist nur ein farbiger Bereich. Ein Konverter muss die Tabellenstruktur aus den räumlichen Beziehungen zwischen diesen unabhängigen Elementen ableiten.
Spaltenerkennung
Um Spalten zu identifizieren, sucht ein Konverter normalerweise nach Headertext ("Datum", "Beschreibung", "Betrag", "Balance") und verwendet ihre x-Positionen, um Spaltengrenzen zu definieren. Aber Header sind nicht immer vorhanden, können unerwartete Terminologie verwenden ("Value Date" anstelle von "Date", "Particulars" statt "Beschreibung"), oder mehrere Zeilen umfassen.
Einige Banken verwenden überhaupt keine sichtbaren Spaltenkopfzeilen — die Spaltenstruktur wird durch das Datenlayout impliziert. In diesen Fällen muss der Konverter Heuristik verwenden: Daten befinden sich in der linken Spalte, Beträge sind rechts ausgerichtet, Beschreibungen sind in der breitesten Spalte.
Zeilenerkennung
Zeilen werden typischerweise durch Gruppierung von Textelementen identifiziert, die dieselbe y-Koordinate (innerhalb einer Toleranz) teilen. Aber Kontoauszüge haben häufig mehrzeilige Zeilen — eine Transaktion, bei der die Beschreibung zu einer zweiten Zeile umhüllt. Der Konverter muss entscheiden: Ist der Text in der nächsten Zeile eine Fortsetzung der aktuellen Transaktion oder der Beginn einer neuen?
Die Antwort hängt vom Kontext ab. Wenn die nächste Zeile ein Datum in der Position der Datumsspalte hat, ist es eine neue Transaktion. Wenn es nur Text in der Position der Beschreibungsspalte hat, ist es eine Fortsetzung. Aber was ist, wenn die nächste Zeile Text hat, der könnte. ein Datum zu sein, ist aber tatsächlich Teil einer Beschreibung? Diese Mehrdeutigkeiten sind, wo Analyse-Fehler auftreten.
Schriftkodierung und Zeichenmapping
Die Zeichen, die Sie in einem PDF sehen, sind nicht immer die Zeichen, die in der Datei gespeichert sind.
Schriftteilmengen
Um die Dateigröße zu reduzieren, betten PDF-Generatoren oft nur die Glyphen (Character Shapes) ein, die tatsächlich im Dokument verwendet werden, nicht die gesamte Schriftart. Die eingebettete Schriftart kann eine benutzerdefinierte Kodierung verwenden, bei der Glyphenindex 65 nicht "A" ist, sondern ein anderes Zeichen. Ein Konverter muss die Kodierungstabelle der Schriftart (ToUnicode CMap oder Encoding Dictionary) lesen, um Glyphen-Indizes wieder auf Unicode-Zeichen zu mappen.
Wenn die Kodierungstabelle unvollständig ist oder fehlt – was bei einigen PDF-Generatoren passiert – muss der Konverter auf Heuristik oder Zeichenerkennung zurückfallen, um festzustellen, welcher Text tatsächlich angezeigt wird.
Zahlenformatierung
Kontoauszüge verwenden verschiedene Zahlenformate:
1,234.56— US-Format mit Komma Tausendertrennzeichen1.234,56— europäisches Format mit Zeit Tausendertrennzeichen(1,234.56)— Klammernotation für negative Zahlen (Debits)-1,234.56— negatives Zeichen für Debits1234.56 CR— Kredit/Debit-Suffix-Notation$1,234.56— mit Währungssymbol
Ein Konverter muss all diese Werte in konsistenten numerischen Werten erkennen und normalisieren. Die Fehlinterpretation eines Tausenden Separators als Dezimalpunkt (oder umgekehrt) macht $1,234,00 in $1.234 aus — ein tausendfacher Fehler.
Sonderzeichen und Kodierungsprobleme
Transaktionsbeschreibungen können Zeichen enthalten, die in PDFs problematisch sind:
- Ampersands, Apostrophes und akzentuierte Charaktere in Handelsnamen
- Referenznummern mit gemischtem alphanumerischen Inhalt
- Charaktere aus nicht-lateinischen Schriften in internationalen Beschreibungen
PDF-Textkodierung ist nicht immer UTF-8. Ältere PDFs können WinAnsiEncoding, MacRomanEncoding oder benutzerdefinierte Kodierungen verwenden. Ein Konverter muss mit all diesen umgehen, um verschmutzte Beschreibungen zu vermeiden.
Wie Banken ihre PDFs erzeugen
Das Verständnis, wie Banken ihre PDFs erstellen, erklärt viel von der Variation der Extraktionsfähigkeit.
Erstellung von Unternehmensdokumenten
Die meisten großen Banken nutzen Plattformen zur Erstellung von Unternehmensdokumenten — Werkzeuge wie OpenText Exstream, Quadient Inspire, oder maßgeschneiderte Systeme. Diese Plattformen nehmen strukturierte Transaktionsdaten aus dem Kernsystem der Bank und machen sie in PDF-Format für die Lieferung an Kunden.
Die Ironie geht bei den Datenextraktionstechnikern nicht verloren: Die Bank beginnt mit perfekt strukturierten Daten, macht sie in ein unstrukturiertes visuelles Format (PDF), und dann muss der Empfänger die Struktur wieder heraus extrahieren. Das PDF ist eine Zwischendarstellung, die genau die Struktur abwirft, die die Daten ursprünglich hatten.
Unterschiedliche Gestaltung von Kontoauszügen
Jede Bank (und manchmal jede Abteilung innerhalb einer Bank) trifft unterschiedliche Design-Entscheidungen:
| Designwahl | Änderung A | Änderung B |
|---|---|---|
| Datumsformat | MM/TT/JJJJ | TT MMM JJJJ |
| Beträge Spalten | Einzelspalte (Negativ für Lastschriften) | Getrennte Debit- und Kreditspalten |
| Bilanzspalte | Finanzierungssaldo je Transaktion | Nur Tagesendsaldo |
| Beschreibung | Einzeilige Linie, gekürzt | Mehrzeilig mit Details |
| Seitenkopfzeilen | Nur Bankname | Vollständige Kontoinformationen auf jeder Seite |
| Zwischensumme | Keine | Tages-, Wochen- oder Seitenteilsummen |
Ein Konverter, der Chase-Kontoauszüge einwandfrei verarbeitet, kann auf Bank of America-Kontoauszüge scheitern, weil jede Designwahl unterschiedlich ist.
Verhalten des PDF-Generators
Die PDF-Rendering-Engine ist ebenfalls wichtig. Einige Generatoren:
- Ausgabetext als komplette Zeichenketten pro Zelle (leichter zu parsen)
- Ausgabe Text Zeichen für Zeichen mit individueller Positionierung (härter)
- Verwenden Sie unsichtbare Textlagen über Bilder (üblich in gescannten und-OCR'd-Dokumenten)
- Einbetten von Schriftarten mit kompletten Kodierungstabellen (zuverlässige Textextraktion) oder Teilmenge mit unvollständigen Mappings (unzuverlässig)
- Zeichne Tabellenzeilen als Vektorgrafiken (hilfreich zur Spaltenerkennung) oder verwende keine sichtbaren Ränder (entferne einen Analyse-Hinweis)
Gescannte und digitale PDFs: zwei unterschiedliche Probleme
PDF-Kontoauszüge kommen in zwei grundsätzlich unterschiedlichen Formen, und sie stellen unterschiedliche Extraktion Herausforderungen.
Digitale (textbasierte) PDFs
Digitale PDFs werden elektronisch generiert – typischerweise von einem Online-Banking-Portal heruntergeladen. Der Text in diesen Dateien wird als Zeichendaten mit Positionsinformationen gespeichert. Ein Konverter kann diesen Text direkt aus dem Content Stream lesen.
Für digitale PDFs ist die Herausforderung rein strukturell: Das Tabellenlayout aus positioniertem Text zu rekonstruieren. Der Text selbst ist genau und vollständig.
Gescannte PDFs (bildbasiert)
Gescannte PDFs sind Fotografien von Papierkontoauszügen. Sie enthalten Rasterbilder – Gitter von Pixeln – ohne Textdaten. Der Content-Stream enthält Bildzeichnungsoperatoren, nicht Textoperatoren.
Um Daten aus einem gescannten PDF zu extrahieren, muss ein Konverter zuerst OCR (Optical Character Recognition) ausführen, um Textregionen im Bild zu erkennen und in maschinenlesbare Zeichen zu konvertieren. Dies fügt zwei zusätzliche Fehler-Modi hinzu:
-
Zeichenerkennungsfehler — OCR kann ähnlich aussehende Zeichen verwechseln: "0" und "O", "1" und "l" und "I", "5" und "S", "8" und "B." In Finanzdaten, wo ein einstelliger Fehler einen Dollarbetrag ändert, ist dies besonders problematisch.
-
Fehler bei der Layouterkennung — OCR muss nicht nur bestimmen, was die Zeichen sind, sondern wo sie positioniert sind. Skewed Scans, variable Auflösung und komplexe Layouts können dazu führen, dass die OCR-Engine Textblöcke verfälscht, angrenzende Spalten zusammenführt oder einzelne Spalten aufteilt.
Ausführliche Hinweise zum Umgang mit gescannten Kontoauszüge finden Sie in unserem Artikel über Umwandlung gescannter Kontoauszüge in CSV. Wenn Sie darüber nachdenken, Papierkontoauszügen breiter zu digitalisieren, dann ist unser Leitfaden zu wie man Kontoauszüge digitalisiert deckt den gesamten Workflow ab.
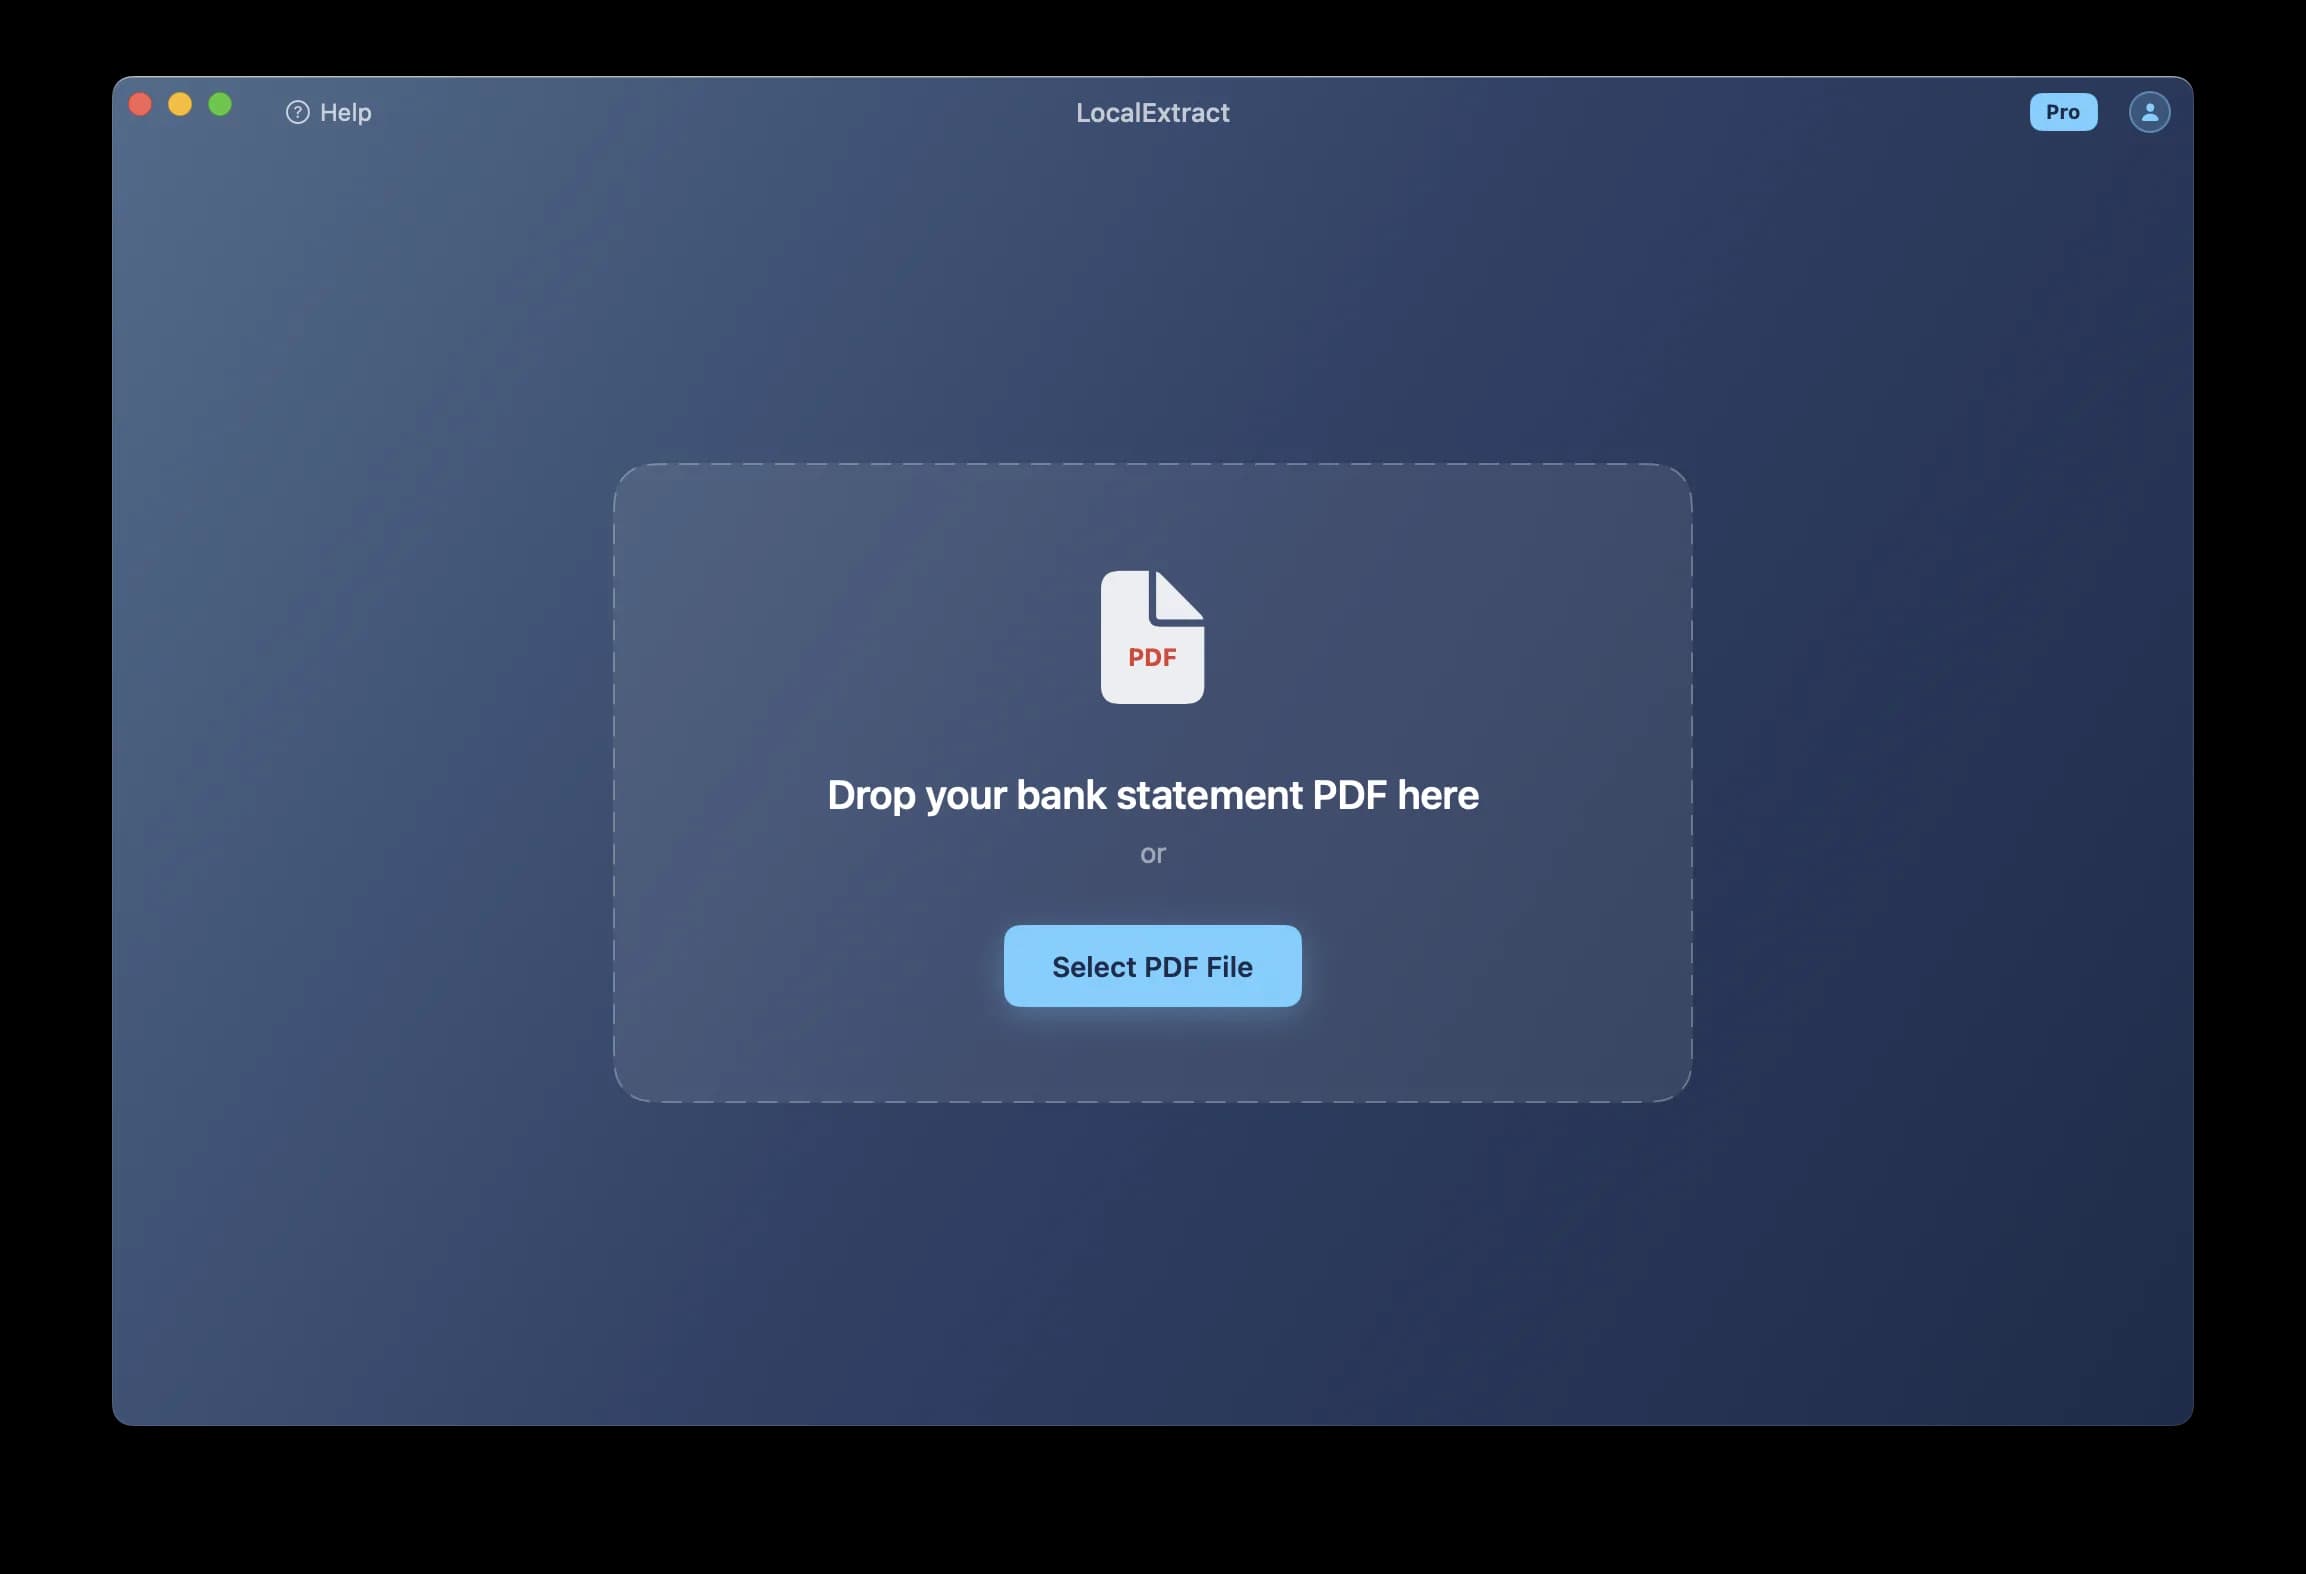
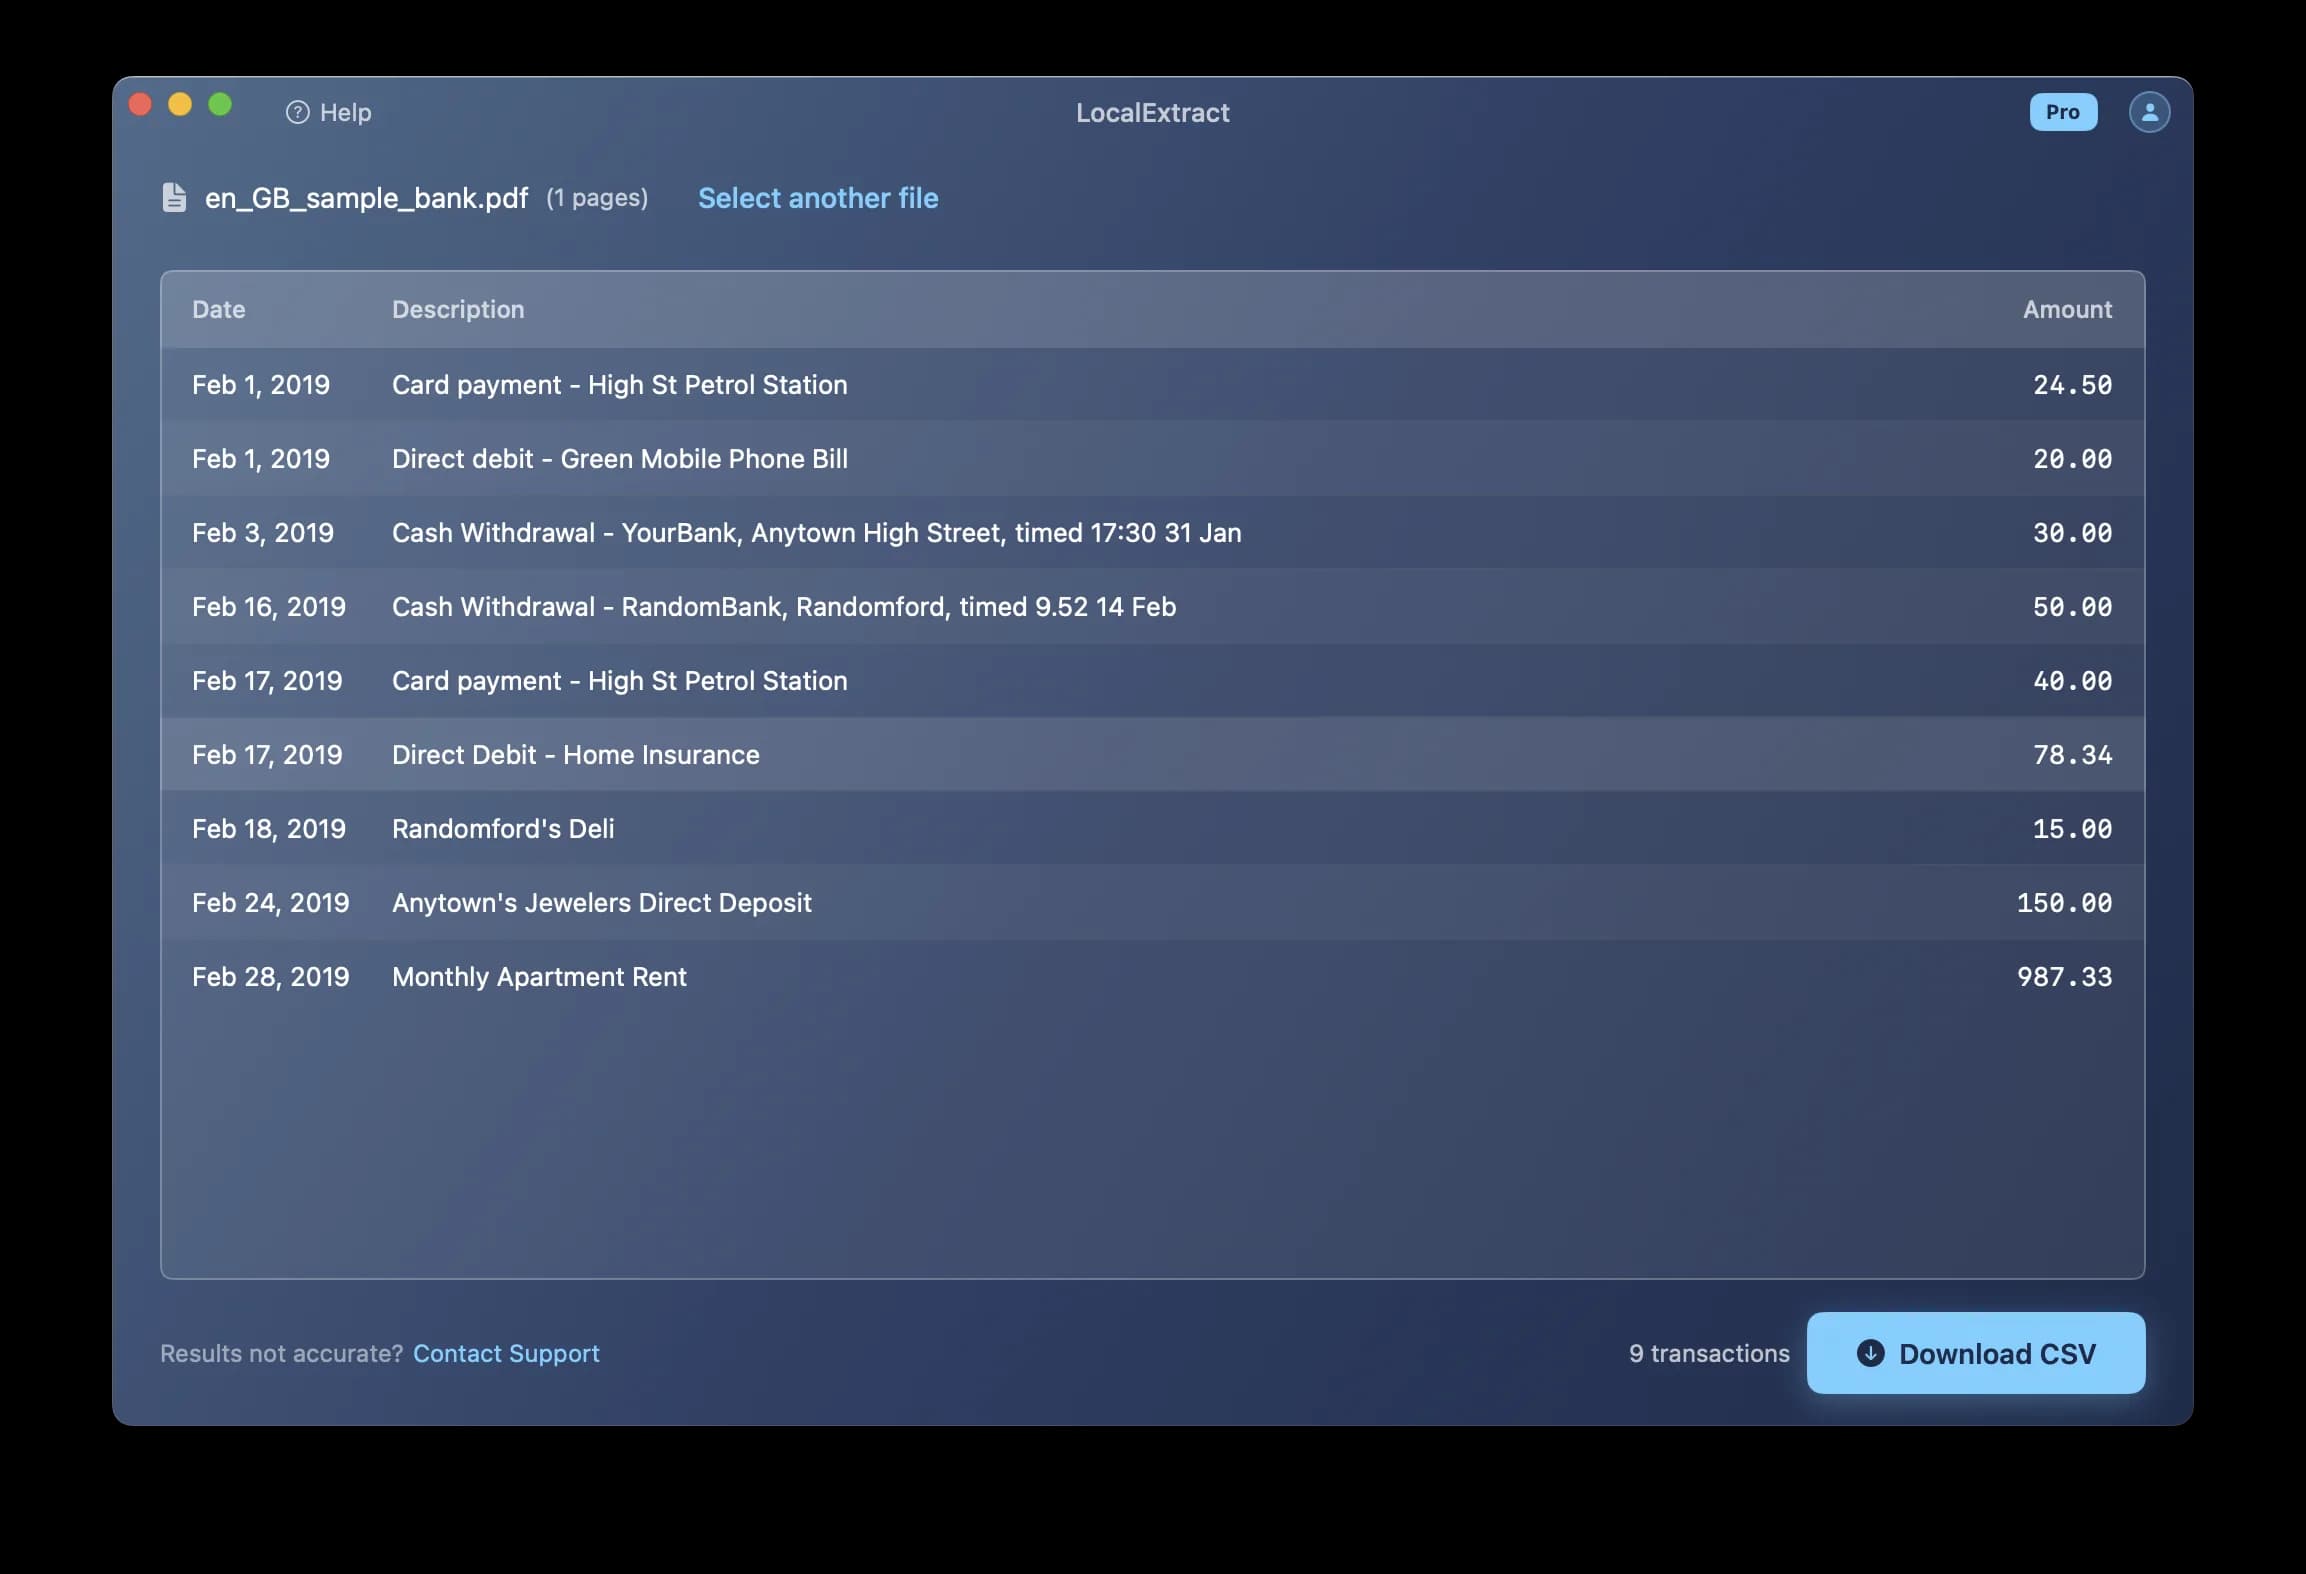
Die Screenshots zeigen allgemeine Arbeitsabläufe, keine überprüften Extraktionsergebnisse für eine bestimmte Bank.
Der hybride Fall
Einige PDFs sind Hybriden: ein gescanntes Bild mit einer unsichtbaren OCR-Textschicht überlagert. Das Bild ist, was Sie sehen; die Textebene ist, was ein Konverter liest. Wenn der OCR von der Bank (oder einem Dokumentenverwaltungssystem) durchgeführt wurde, hängt die Qualität der Textebene davon ab, wann und wie der OCR ausgeführt wurde. Einige OCR-Textlagen sind hochgenau; andere enthalten signifikante Fehler, die für den Benutzer, der die Seite betrachtet, unsichtbar sind.
Mehrspaltige Layouts und visuelle Mehrdeutigkeit
Kontoauszüge verwenden häufig Multi-Spalten-Layouts, die Mehrdeutigkeit für automatisierte Extraktion erzeugen.
Das Problem mit Soll- und Habenspalten
Viele Banken verwenden getrennte Debit- und Kreditspalten statt einer einzigen Betragsspalte. Optisch hat jede Transaktion einen Betrag entweder in der Debitspalte oder in der Kreditspalte, aber nicht in beiden. Im PDF-Inhaltsstrom wird der Beträgestring an einer bestimmten x-Koordinate positioniert. Ein Konverter muss feststellen, ob die x-Koordinate in die Debitspalte oder die Kreditspalte fällt.
Sind die Spaltenkopfzeilen ("Debit" und "Credit") vorhanden und klar positioniert, ist dieses Mapping einfach. Wenn die Kopfzeilen fehlen, gekürzt oder mehrdeutig positioniert werden, muss der Konverter kontextuelle Hinweise verwenden – wie z.B. ob Beträge in der linken Spalte dazu neigen, das laufende Gleichgewicht zu verringern.
Zusammenfassungen, die wie Buchungen aussehen
Viele Kontoauszüge umfassen Zusammenfassungen — tägliche Summen, monatliche Durchschnittswerte, Zinsberechnungen —, die dasselbe Layout und dieselbe Formatierung verwenden wie die Transaktionstabelle. Ein Konverter, der diese Abschnitte nicht spezifisch erkennt und ausschließt, wird falsche Einträge in der Ausgabe enthalten.
Werbeinhalte und Offenlegungen
Kontoauszüge beinhalten häufig Marketing-Nachrichten, gesetzliche Offenlegungen und Kontokonditionen, die mit Finanzdaten vermischt sind. Diese Textblöcke können in den gleichen Seitenbereich wie die Transaktionstabelle fallen. Ein Konverter muss zwischen Transaktionsdaten und Nichttransaktionsinhalten unterscheiden, in der Regel indem er die Struktur analysiert (hat dieser Text ein Datum und eine Betrag?) und nicht den Inhalt (welches natürliche Sprachverständnis erfordern würde).
Störungen durch Kopfzeilen, Fußzeilen und Seitenumbrüche
Mehrseitige Kontoauszüge führen zu zusätzlicher Komplexität.
Wiederholte Kopfzeilen
Die meisten Banken wiederholen die Spaltenkopfzeilen auf jeder Seite. Ein Konverter muss erkennen, dass der Text "Date Description Amount Balance" auf Seite 3 ist ein Seitenkopf, nicht eine Transaktion. Wenn der Konverter jedes Auftreten dieser Header-Strings als Daten behandelt, enthält die Ausgabe falsche Zeilen.
Fußzeilen und laufende Summen
Seitenfußzeilen können laufende Gesamtsummen ("Seite insgesamt: $12,345,67"), Kontozusammenfassungen oder Paginationstext ("Seite 3 von 8") umfassen. Diese erscheinen oft im gleichen Bereich der Seite wie die letzte Transaktionszeile und erzeugen Unklarheiten darüber, wo die Transaktionstabelle endet und die Fußzeile beginnt.
Transaktionen auf Seiten aufgeteilt
Eine Transaktion, deren Beschreibung in mehrere Zeilen wickelt, kann über einen Seitenbruch aufgeteilt werden. Das Datum und die erste Zeile der Beschreibung erscheinen am Ende einer Seite; die Fortsetzung der Beschreibung erscheint oben auf der nächsten Seite (nach dem wiederholten Header). Ein Konverter muss dies anmutig handhaben — entweder indem er die Fortsetzung erkennt und mit der vorherigen Transaktion verschmilzt, oder indem er die Fortsetzung zumindest nicht als separate Transaktion mit einem fehlenden Datum und Betrag behandelt.
Unterschiedliche Fußzeilenhöhen
Nicht alle Seiten haben die gleiche Fußhöhe. Die letzte Seite einer Kontoauszug hat in der Regel eine längere Fußzeile mit Kontozusammenfassung Informationen, Rechtstext und Bankkontaktdaten. Ein Konverter, der eine feste Anbaufläche verwendet, um Fußzeilen auszuschließen, schneidet entweder die Transaktionen auf kurzfüßigen Seiten ab oder enthält Fußzeilentext auf langfüßigen Seiten.
Warum manche Bankformate leichter auszulesen sind
Angesichts all der oben genannten Herausforderungen sollte klar sein, warum die Konvertergenauigkeit zwischen den Banken variiert. Hier sind die Faktoren, die einige Banken Kontoauszüge leichter zu parsen:
Saubere Textausgabe
Banken, deren PDF-Generatoren Text als komplette Zeichenketten ausgeben (eine Zeichenkette pro Zelle) sind viel einfacher zu parsieren als diejenigen, die Textzeichen-für-Zeichen mit individueller Positionierung ausgeben. Ersteres gibt dem Konverter sauberen, lesbaren Text; letzteres erfordert Rekonstruktion aus Fragmenten.
Konsistente Layouts
Banken, die das gleiche Layout für alle Kontotypen und Abrechnungsperioden verwenden, sind leichter zu unterstützen als Banken, die ihr Layout nach Kontotyp variieren (Überprüfung vs. Sparen vs. Kreditkarte), Abrechnungszeitraum (monatlich vs. Quartal), oder sogar im Laufe der Zeit, wenn sie ihre Erklärungsgestaltung aktualisieren.
Klare Spaltengrenzen
Banken, die sichtbare Tabellengrenzen zeichnen, bieten explizite Spaltengrenzen, die ein Konverter erkennen kann. Banken, die grenzenlose Tabellen mit nur Leerzeichen zwischen Spalten verwenden, zwingen den Konverter, Grenzen von der Textpositionierung abzuleiten – was meistens funktioniert, aber fehlschlägt, wenn die Beschreibungen lang genug sind, um sich dem Gebiet der angrenzenden Spalte zu nähern.
Standardformatierung
Banken, die Standard-Datumsformate (MM/DD/YYYY), Standard-Nummernformate (1.234.56) und Single-Line-Beschreibungen verwenden, sind einfacher zu lesen als Banken, die ungewöhnliche Formate, mehrzeilige Beschreibungen oder eingebettete Memos verwenden.
Keine Unordnung
Banken, die nichttransaktionsbezogene Inhalte (Marketing, Offenlegungen, Bedingungen) auf separaten Seiten oder deutlich von der Transaktionstabelle getrennt halten, sind einfacher zu lesen als Banken, die Werbeinhalte in den Transaktionsbereich mischen.
Wie Konverter diese Probleme lösen
Wie funktionieren die Kontoauszugskonverter angesichts dieser Herausforderungen tatsächlich?
Regelbasierte Ansätze
Der traditionelle Ansatz verwendet handgefertigte Regeln für jedes bekannte Bankformat. Der Konverter identifiziert die Bank (aus dem Statement Header), wählt den entsprechenden Satz von Regeln (Spaltenpositionen, Datumsformat, Zahlenformat) und wendet sie an. Dies erzeugt eine hohe Genauigkeit für unterstützte Banken, scheitert aber in unbekannten Formaten.
Ansätze für maschinelles Lernen
Einige Konverter verwenden trainierte Modelle, um Tabellenstrukturen zu erkennen, Spaltenrollen zu identifizieren und Textelemente zu klassifizieren. Dieser Ansatz kann unbekannte Formate besser handhaben als reine regelbasierte Systeme, erfordert jedoch große Trainingsdatensätze und kann weniger vorhersehbare Fehler verursachen.
Hybride Ansätze
Die meisten modernen Konverter, einschließlich LocalExtract, verwenden eine Kombination: Allzweck-Layoutanalysealgorithmen, die über viele Bankformate hinweg funktionieren, ergänzt durch bankspezifische Konfigurationen für bekannte Formate. Dies gleicht die Abdeckung mit Genauigkeit aus. Für einen breiteren Überblick darüber, wie Konverter arbeiten, siehe unsere vollständige Anleitung für Kontoauszug-Konverter.
Die ständige Herausforderung für Konverter-Entwickler ist die Erweiterung der Formatabdeckung bei gleichzeitiger Aufrechterhaltung der Genauigkeit — eine Aufgabe, die nie wirklich "fertig" ist, weil Banken regelmäßig aktualisieren ihre Statement-Designs, Einführung neuer Layout-Variationen, die bestehende Parser möglicherweise nicht richtig behandeln. Ein praktischer Leitfaden für den Konversionsprozess aus Sicht des Nutzers finden Sie unter was ist ein Kontoauszug-Konverter.
Ausblick
Die technische Landschaft des Kontoauszuges entwickelt sich in mehrere Richtungen. On-device Machine Learning Modelle werden leistungsfähig genug, um Layout-Analysen ohne Cloud-GPU-Infrastruktur zu handhaben — eine Verschiebung, die Offline-Konverter für Kontoauszüge um die Cloud-Genauigkeit für die meisten Formate anzupassen. Große Sprachmodelle werden erforscht, um komplexe Finanzdokument-Layouts zu verstehen, obwohl die Präzisionsanforderungen an Finanzdaten (wobei eine falsch platzierte Dezimalstelle ein kritischer Fehler ist) ihre eigenständige Anwendbarkeit heute einschränken. Die PDF-Spezifikation selbst entwickelt sich weiter — ISO 32000-2 hat Verbesserungen eingeführt, um die PDF-Struktur zu markieren — aber die Bank nimmt Barrierefreiheit-freundliche markierte PDFs nur langsam an. Der vielleicht einflussreichste Trend ist der allmähliche Wandel hin zur strukturierten Datenbereitstellung (Open Banking APIs, ISO 20022 Messaging), der schließlich die Abhängigkeit von PDF-Kontoauszüge insgesamt verringern kann, obwohl dieser Übergang in Jahrzehnten und nicht in Jahren gemessen wird. Für Buchhaltungsfachkräfte, die sich mit heutigen PDF-Kontoauszüge beschäftigen, hilft das Verständnis dieser Formatherausforderungen zu erklären, warum Zweckgerichtete Konverter für Kleinunternehmen existieren und warum generische PDF-Tools oft fehlen.
Häufige Fragen
Warum kann ich nicht einfach aus einem PDF kopieren und einfügen? Wenn Sie Text aus einem PDF kopieren, erhalten Sie die Zeichen, verlieren aber die räumlichen Beziehungen, die die Tabellenstruktur definieren. Text aus verschiedenen Spalten wird in Lesereihenfolge verkettet, Daten mit Beschreibungen verschmelzen und Beträge verlieren ihre Spaltenausrichtung. Das Ergebnis ist ein unstrukturierter String, keine Tabelle.
Was ist ein PDF-Inhaltsstrom? Ein Inhaltstrom ist der Teil eines PDF, der Zeichnungsanweisungen enthält – Operatoren, die festlegen, an welcher Stelle welcher Text in welcher Schriftart und Größe zu rendern ist. Es enthält auch Operatoren für das Zeichnen von Linien, Formen und Bildern. Content-Streams sind das Rohmaterial, das Text zu extrahieren und Seitenlayout zu rekonstruieren Parse konvertiert.
Warum versagen einige Konverter auf den Kontoauszüge meiner Bank? Jede Bank PDF ist anders strukturiert. Wenn ein Konverter nicht für das spezifische Layout, das Datumsformat, die Spaltenanordnung und den Textausgabestil Ihrer Bank konfiguriert oder trainiert wurde, kann er die Daten verfälschen. Die Berichterstattung über das nicht unterstützte Format an den Entwickler des Konverters führt in der Regel zu einer verbesserten Unterstützung bei zukünftigen Updates.
Sind gescannte PDFs schwieriger zu konvertieren als digitale? Bezeichnenderweise. Digitale PDFs enthalten exakte Textdaten. Gescannte PDFs enthalten Bilder, die zuerst von OCR verarbeitet werden müssen, um den Text wiederherzustellen, und fügen eine Ebene hinzu, in der Erkennungsfehler auftreten können. Niedrigauflösende Scans, verdrehte Seiten und verblasster Druck reduzieren die OCR-Genauigkeit weiter.
Kann KI das Problem der PDF-Extraktion lösen? KI und maschinelles Lernen verbessern die Extraktionsqualität, insbesondere für den Umgang mit unbekannten Layouts und gescannten Dokumenten. Finanzdaten erfordern jedoch eine nahezu perfekte Genauigkeit (ein falsch platzierter Dezimalpunkt ändert einen Dollarbetrag um den Faktor 10), und aktuelle KI-Modelle erreichen diese Genauigkeit bei allen Dokumententypen nicht konsequent. Hybride Ansätze, die regelbasierte Analyse mit ML-basierte Layouterkennung kombinieren, liefern derzeit die zuverlässigsten Ergebnisse.
Wie geht LocalExtract mit diesen Herausforderungen um? LocalExtract verwendet eine Rust-basierte Extraktionsmaschine mit PDFium zur Textextraktion und PP-OCRv5 für gescannte Dokumente. Es verwendet eine allgemeine Layout-Analyse, die durch bankspezifische Konfiguration für bekannte Formate ergänzt wird. Die Verarbeitung erfolgt vollständig auf Ihrem Gerät (macOS und Windows), halten Ihre Daten privat - siehe unsere private Kontoauszug-Konverter Leitfaden für die Frage, warum das zählt. Die kostenlose Nutzung umfasst 10 Seiten; der Pro-Plan beträgt $10/Monat oder $60/Jahr.
LocalExtract konvertiert den PDF-Kontoauszüge in CSV für die Verwendung in Excel ganz auf Ihrem Gerät – keine Uploads, keine Cloud-Verarbeitung, kein Zugriff von Drittanbietern auf Ihre Finanzdaten. Verfügbar für macOS und Windows.
LocalExtract Team
Wir entwickeln LocalExtract, einen Kontoauszug-Konverter für den Desktop. Fragen oder Korrekturen? Kontakt · Redaktionsrichtlinien