
Comprendre le format PDF des relevés bancaires
Mis à jour · 25 min de lecture
Points clés
- PDF est un langage de description de page, pas un format de données — il contient des instructions pour dessiner du texte à des coordonnées spécifiques, et non des lignes et des colonnes.
- relevé de compte bancaire PDFs n'ont pas de sémantique de table: la "table" que vous voyez est une illusion visuelle créée par le texte aligné et les lignes tracées.
- Chaque banque génère des PDF différemment — l'ordre des colonnes, les formats de date, le formatage des numéros, les descriptions multilignes et la gestion des pauses de page varient.
- Les PDF scannés (basés sur l'image) ajoutent une couche de difficulté supplémentaire : OCR doit reconstruire le texte à partir de pixels avant que toute analyse de table puisse commencer.
- Comprendre ces défis techniques explique pourquoi les outils génériques « PDF à Excel » échouent souvent sur les relevés de compte bancaires, et pourquoi il existe des convertisseurs spécialement conçus.
Cet article est destiné à des fins éducatives. Aucune connaissance technique spécifique n'est requise, bien que les lecteurs ayant une expérience de programmation puissent trouver les exemples de code particulièrement informatifs.
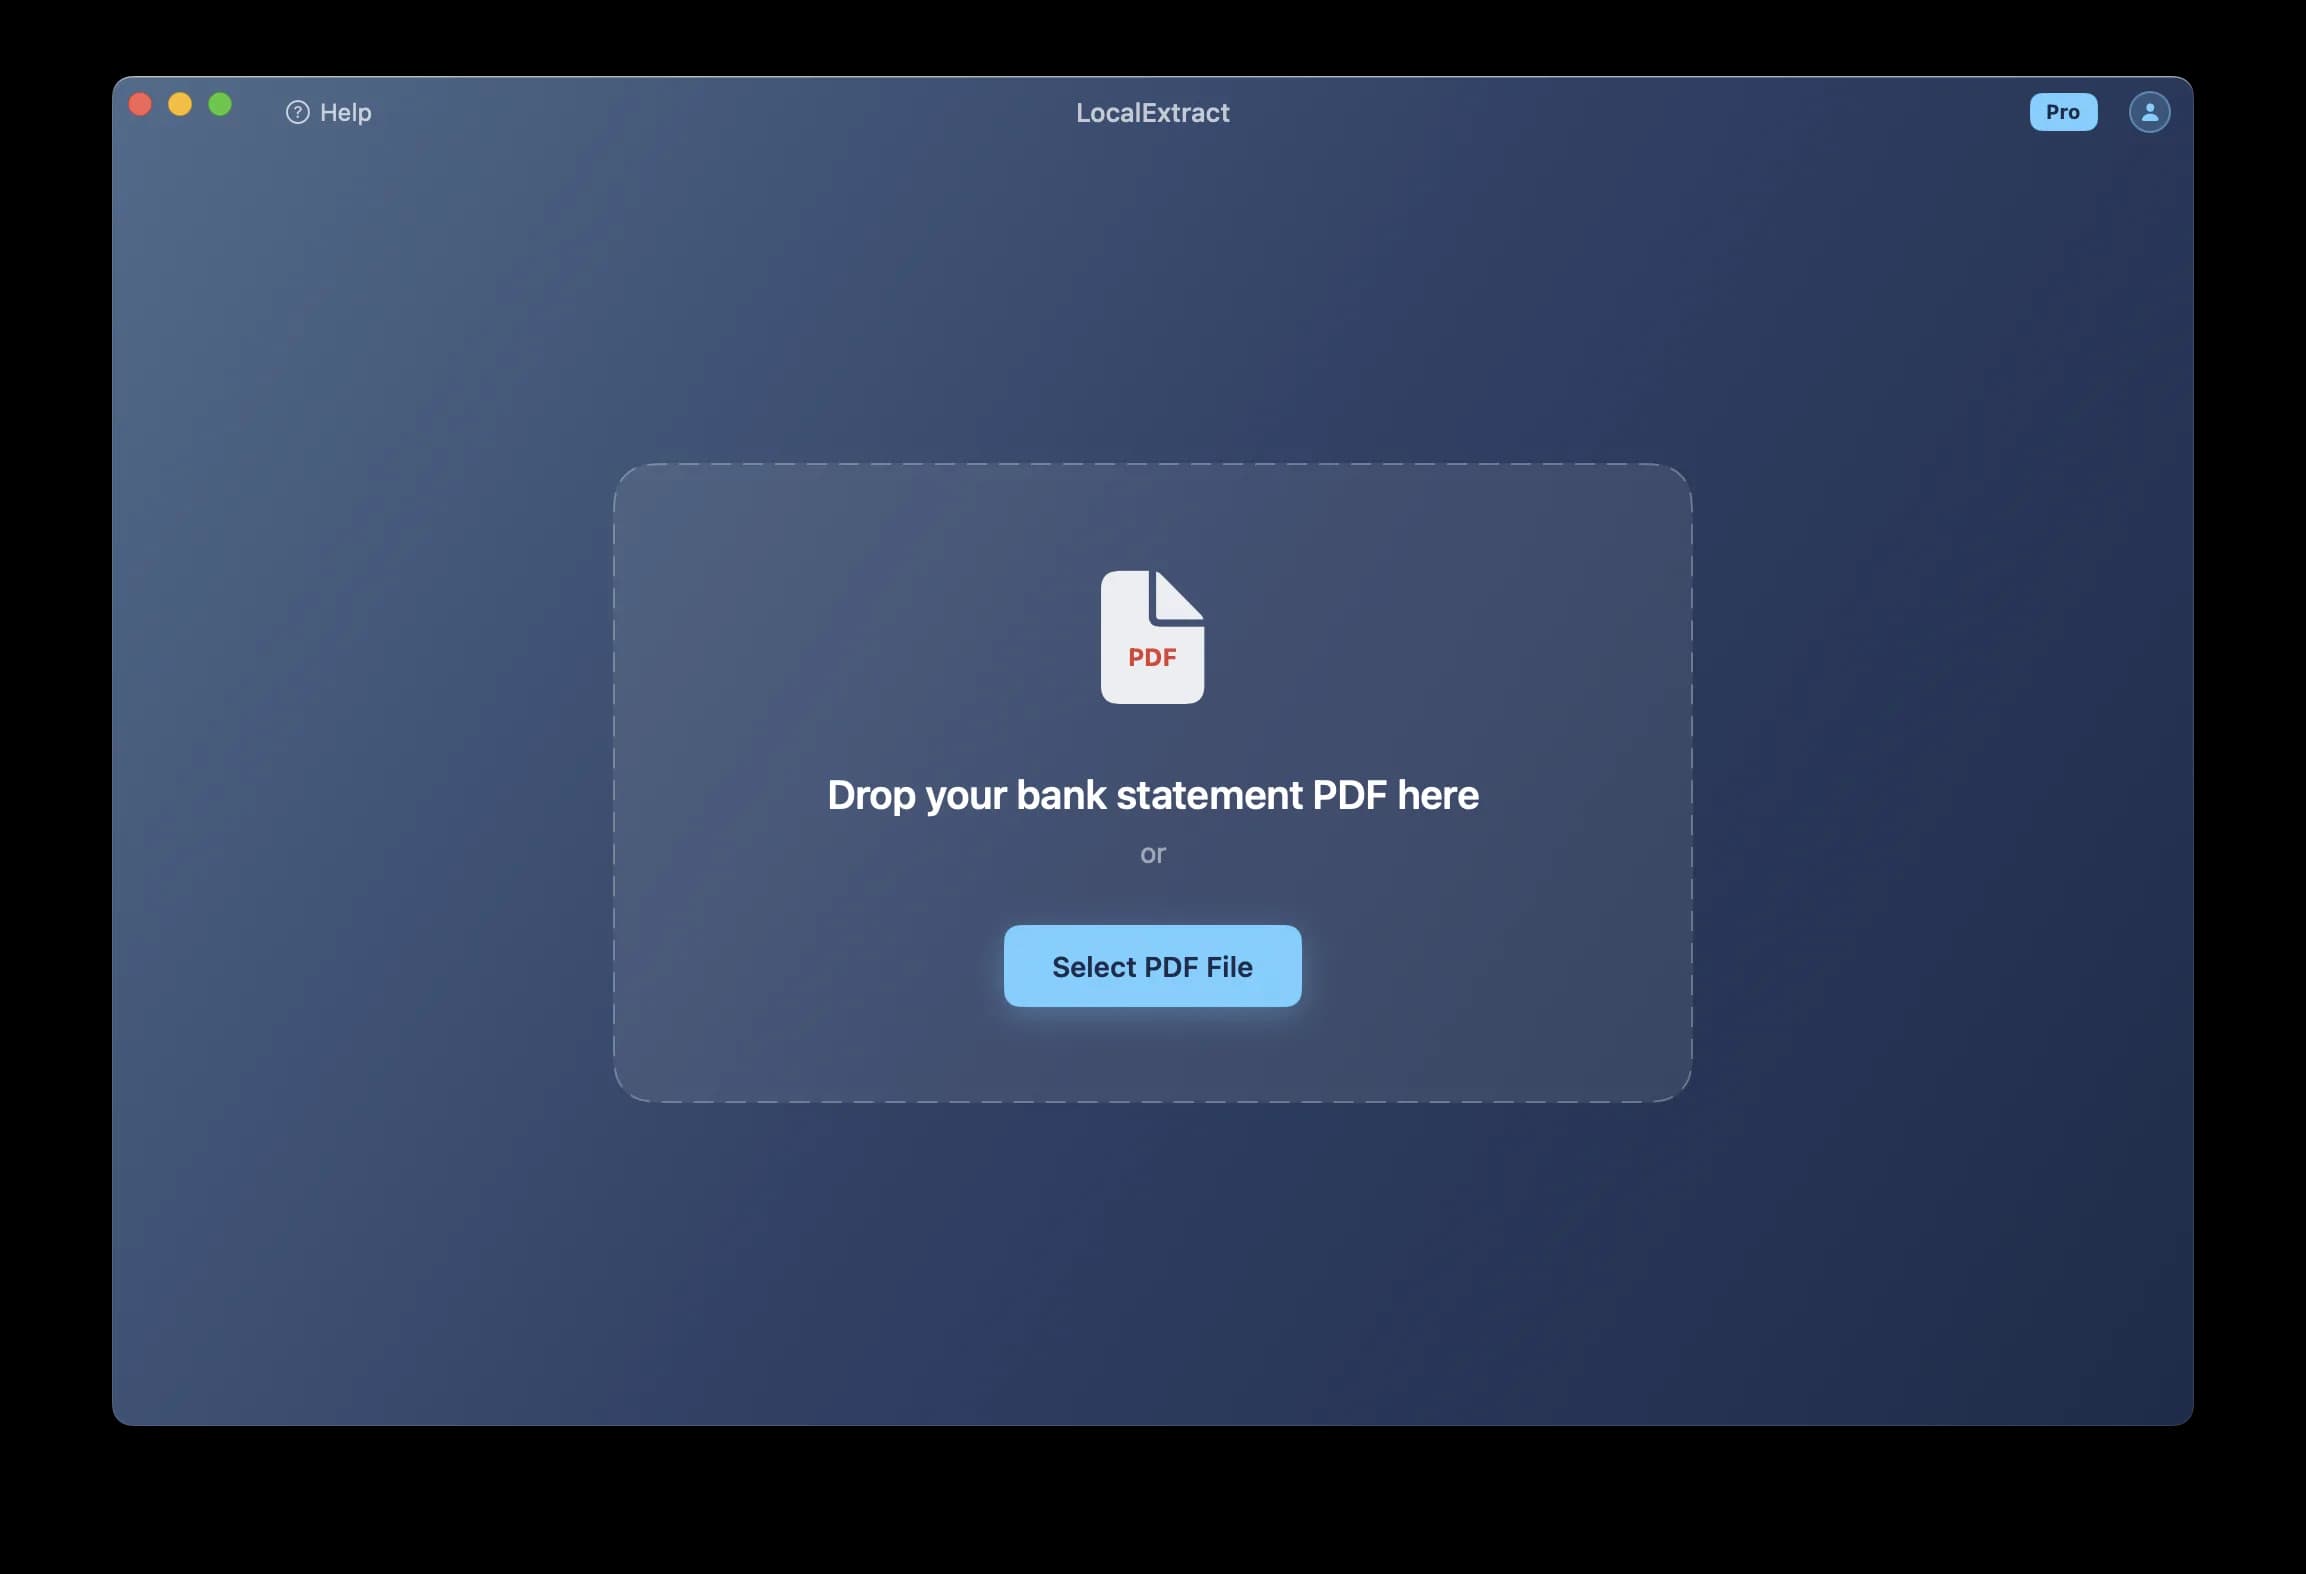
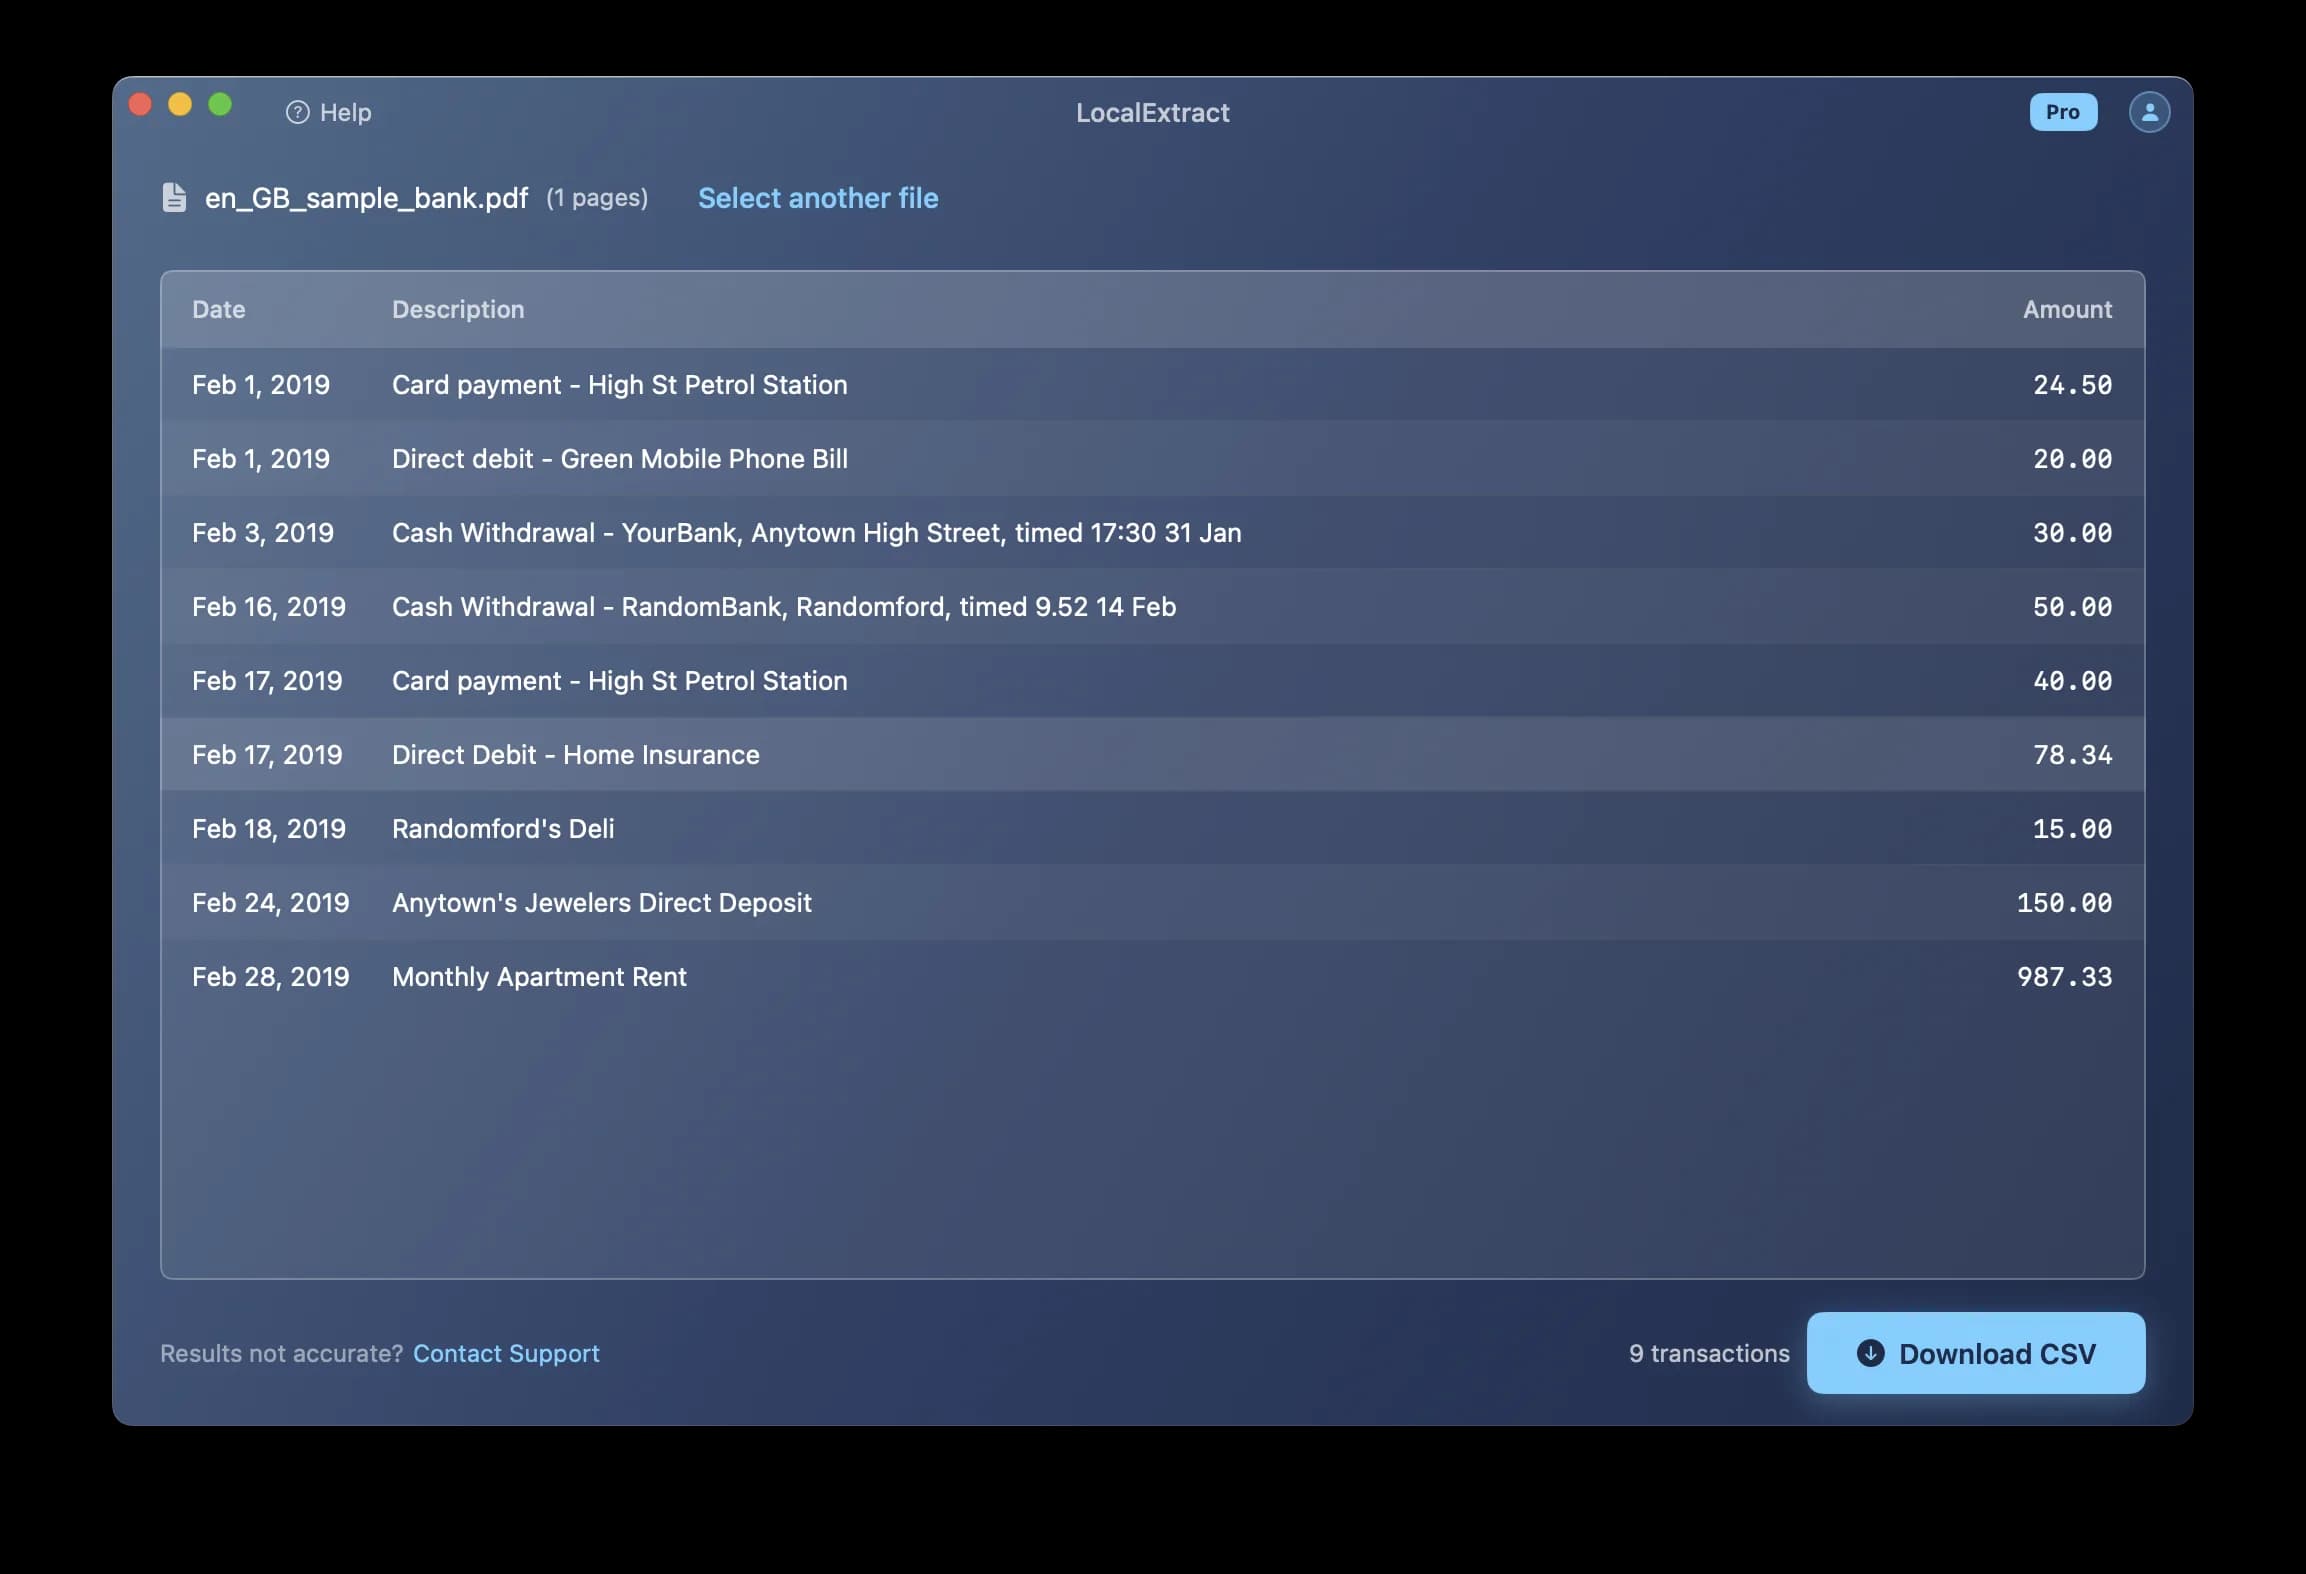
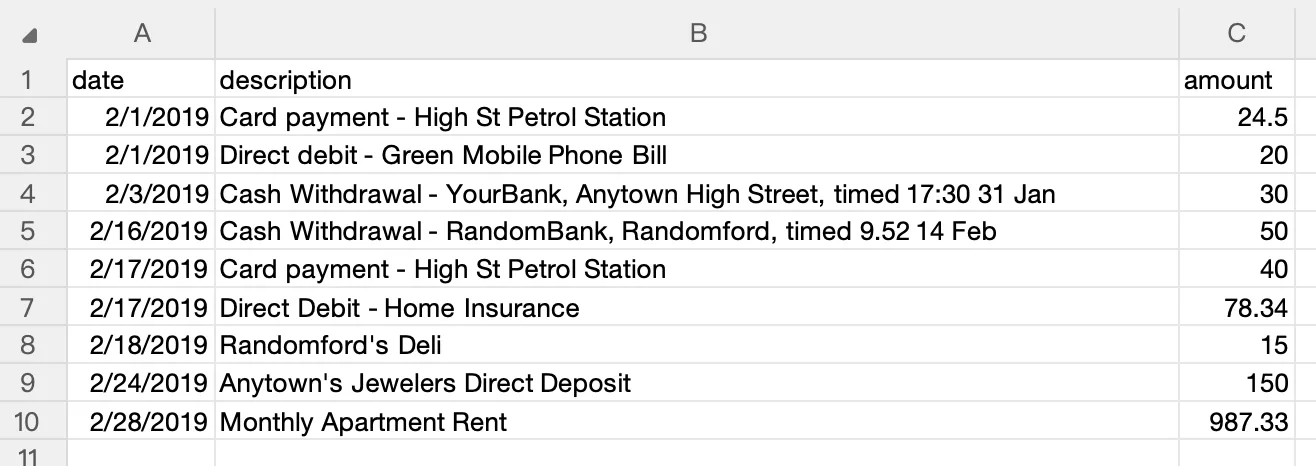
Fonctionnalités de l’application de bureau LocalExtract : Exportez un PDF sélectionné à la fois en CSV avec les colonnes
date,descriptionetamount. Ouvrez le fichier CSV dans Excel et enregistrez-le en XLSX si nécessaire. L’application ne propose ni file d’attente par lots, ni export JSON, QBO ou OFX, ni synchronisation comptable. L’analyse PDF et l’OCR s’exécutent localement. Les services de compte, d’abonnement et de mise à jour nécessitent Internet, y compris la vérification périodique de l’abonnement Pro. Testez votre propre relevé et vérifiez chaque ligne : une langue prise en charge ou un guide bancaire ne garantit pas la compatibilité avec tous les formats de relevés.
Les applications exportent la date, la description et le montant en CSV. Ouvrez ce CSV dans Excel pour enregistrer un classeur XLSX. Vérifiez le résultat avec votre PDF : la compatibilité dépend du format du relevé.
Le problème fondamental
Lorsque vous ouvrez un relevé de compte bancaire PDF et que vous voyez un tableau des transactions bien formaté, votre cerveau reconnaît sans effort la structure. Vous voyez les colonnes : Date, Description, Montant, Solde. Vous voyez les lignes : une par transaction. Vous voyez une table.
Transparence : cet article est publié par l’équipe LocalExtract, qui développe le convertisseur de bureau et a un intérêt commercial dans ce sujet. Comparez les lignes exportées à votre propre relevé. Les guides bancaires et les captures d’écran générales ne garantissent pas la compatibilité.
Le fichier PDF ne voit rien de tout cela. Dans le PDF, il n'y a pas de table. Il n'y a pas de colonnes. Il n'y a pas de rangées. Il n'y a que des instructions pour placer des caractères et des chaînes à des coordonnées x,y spécifiques sur une page. La table est une propriété visuelle émergente — elle existe dans le rendu, pas dans les données.
C'est la raison fondamentale pour laquelle l'extraction des données du relevé de compte bancaire PDFs est difficile. Chaque convertisseur doit combler l'écart entre ce que le PDF contient en fait (des fragments de texte placés) et ce que les humains voir (données de transaction structurées). Cet article explique exactement ce qui se trouve à l'intérieur d'un relevé de compte bancaire PDF et pourquoi il rend l'extraction difficile.
Ce que contient réellement un PDF
Un fichier PDF est structuré autour de quelques concepts clés :
Objets et flux de contenu
Un PDF se compose d'objets — dictionnaires, tableaux, chaînes de caractères, nombres et flux. Le contenu visuel de chaque page vit dans un flux de contenu: une séquence d'opérateurs qui décrivent ce qu'il faut dessiner et où le dessiner.
Voici un exemple simplifié de ce qu'un flux de contenu pourrait ressembler à l'intérieur d'un relevé de compte bancaire PDF:
BT                          % Begin text block
/F1 10 Tf                   % Set font to F1, size 10pt
72 720 Td                   % Move to position x=72, y=720
(03/15/2026) Tj             % Draw the string "03/15/2026"
180 0 Td                    % Move 180 points to the right
(Direct Deposit - Payroll) Tj  % Draw the description
270 0 Td                    % Move 270 points to the right
(2,500.00) Tj               % Draw the amount
ET                          % End text block
Ceci dessine trois cordes sur la page. Pour un humain qui lit la page rendue, ils forment une rangée d'une table de transaction. Pour un ordinateur qui lit le flux de contenu, il s'agit de trois chaînes non reliées placées à trois positions horizontales différentes sur la même ligne verticale.
Système de coordonnées
PDF utilise un système de coordonnées où (0,0) est généralement le coin inférieur gauche de la page. L'axe des x court de gauche à droite; l'axe des y tourne de bas en haut. Une page de lettre standard des États-Unis est 612 x 792 points (8,5 x 11 pouces à 72 points par pouce).
Les positions sont spécifiées dans les nombres de points flottants, ce qui signifie que le texte n'est pas aligné sur une grille. Deux cordes qui apparaissent alignées verticalement peuvent avoir des coordonnées y de 720,0 et 719.8 — assez proches pour être rendues sur la même ligne, mais techniquement à des positions différentes. Un convertisseur doit décider de la tolérance à utiliser lors du regroupement du texte en lignes.
Pas de marquage sémantique
HTML a <table>, <tr>, <td>C'est vrai. PDF n'a rien de tout ça. La spécification PDF (ISO 32000) définit le terme « PDF tagué » avec des éléments structuraux, mais en pratique presque aucun relevé de compte bancaire PDF utilise la structure étiquetée. La grande majorité des PDF générés par les banques sont démarqués — le flux de contenu est la seule source d'information, et il ne contient que des relevés de dessin.
Positionnement du texte : le problème de coordonnées x,y
Chaque morceau de texte dans un PDF a une position. Cela semble devoir rendre l'extraction simple — il suffit de lire le texte et ses coordonnées, de grouper par position, et de reconstruire le tableau. Dans la pratique, plusieurs complications surviennent.
Transformations de la matrice du texte
Le positionnement du texte PDF n'est pas simplement "placer la chaîne à (x,y)". La position du texte est déterminée par une combinaison de la matrice de texte (opérateur Tm), mouvement du texte les exploitants (Td, TD, T*) et matrice de transformation actuelle (CTM). Il peut s'agir de l'échelle, de la rotation et de la traduction. Un convertisseur doit suivre tous ces changements d'état pour déterminer la position réelle rendue de chaque fragment de texte.
1 0 0 1 72 720 Tm        % Set text matrix: translate to (72, 720)
(Transaction) Tj          % Draw text at the matrix position
14 0 Td                   % Move right by 14 points for next string
(Date) Tj                 % This appears immediately after "Transaction"
Dans cet exemple, "Transaction" et "Date" sont deux chaînes distinctes qui forment ensemble l'en-tête "Transaction Date". Un convertisseur doit reconnaître qu'elles doivent être fusionnées en fonction de leur proximité, mais il n'y a aucune indication explicite dans le PDF que ces deux chaînes forment un seul élément logique.
Positionnement caractère par caractère
Certains générateurs PDF produisent du texte un caractère à la fois, avec des réglages de positionnement individuels pour le kerning:
[(T) 20 (r) -10 (ansaction)] TJ
L'opérateur TJ prend un tableau où les nombres représentent des ajustements de kerning (en millièmes d'une unité d'espace texte). Le convertisseur doit réassembler ces fragments de caractères en cordes lisibles, en appliquant les réglages de positionnement pour déterminer l'espacement. Un grand ajustement positif pourrait indiquer une pause mot; un petit ajustement est juste kerning.
Différences de positionnement des sous-pixels
Deux rangées d'une table qui apparaissent parfaitement alignées peuvent avoir des coordonnées Y légèrement différentes en raison de la précision du point flottant dans le générateur PDF. La ligne 1 peut être à y=540.0 et la ligne 2 à y=527.2 (une ligne vers le bas), mais si une troisième chaîne est à y=540.1, fait-elle partie de la ligne 1 ou d'un élément distinct? Pour cela, les convertisseurs ont besoin d'algorithmes de regroupement basés sur la tolérance.
Absence de structure sémantique des tableaux
Il s'agit là du défi technique le plus important en matière d'extraction des relevés bancaires.
Les tableaux visuels ne sont pas des tableaux de données
Lorsqu'une banque génère un PDF d'état, le moteur de rendu dessine :
- Chaînes de texte à positions calculées (formant le contenu apparent de la cellule)
- Lignes ou rectangles (formant les bords apparents des cellules)
- Remplissages de fond (créant des ombrages alternés des rangées)
Aucun de ces éléments n'est lié sémantiquement. La ligne tracée à y=530 n'est pas associée au texte à y=540. Le rectangle ombragé n'est pas un « rang » — c'est juste une zone de couleur. Un convertisseur doit déduire la structure de la table à partir des relations spatiales entre ces éléments indépendants.
Détection des colonnes
Pour identifier les colonnes, un convertisseur recherche généralement le texte d'en-tête ("Date", "Description", "Montant", "Balance") et utilise leurs positions x pour définir les limites des colonnes. Mais les en-têtes ne sont pas toujours présents, peuvent utiliser une terminologie inattendue ("Value Date" au lieu de "Date", "Particuliers" au lieu de "Description"), ou peuvent s'étendre sur plusieurs lignes.
Certaines banques n'utilisent pas du tout des en-têtes de colonnes visibles — la structure des colonnes est implicite par la mise en page des données. Dans ces cas, le convertisseur doit utiliser l'heuristique: les dates sont dans la colonne la plus à gauche, les montants sont alignées à droite, les descriptions sont dans la colonne la plus large.
Détection des lignes
Les lignes sont généralement identifiées en regroupant des éléments de texte qui partagent la même coordination y (dans le cadre d'une tolérance). Mais les relevés de compte bancaires comportent souvent des lignes multilignes, une opération où la description se termine par une deuxième ligne. Le convertisseur doit décider: le texte sur la ligne suivante est-il une continuation de la transaction en cours, ou le début d'une nouvelle transaction?
La réponse dépend du contexte. Si la ligne suivante a une date dans la position de la colonne de date, il s'agit d'une nouvelle transaction. S'il n'a de texte que dans la position de la colonne description, il s'agit d'une suite. Mais si la ligne suivante avait du texte pourrait être une date, mais fait-elle partie d'une description? Ces ambiguïtés sont l'endroit où des erreurs d'analyse se produisent.
Encodage des polices et cartographie des caractères
Les caractères que vous voyez dans un PDF ne sont pas toujours les caractères stockés dans le fichier.
Sous-ensembles de polices
Pour réduire la taille du fichier, les générateurs PDF intègrent souvent seulement les glyphes (forme de caractères) utilisés dans le document, et non la police entière. La police intégrée peut utiliser l'encodage personnalisé où glyph index 65 n'est pas "A" mais un autre caractère. Un convertisseur doit lire la table d'encodage de la police (ToUnicode CMap ou dictionnaire Encoding) pour cartographier les indices glyphes de retour aux caractères Unicode.
Lorsque la table d'encodage est incomplète ou manquante — ce qui arrive avec certains générateurs PDF — le convertisseur doit revenir à l'heuristique ou à la reconnaissance de caractères pour déterminer quel texte est réellement affiché.
Format des nombres
les états de compte bancaires utilisent différents formats de nombres:
1,234.56— format américain avec virgule milliers de séparateurs1.234,56— format européen avec séparateur de milliers de périodes(1,234.56)— notation par parenthèses pour les nombres négatifs (débits)-1,234.56— signe négatif pour les débits1234.56 CR— notation de suffixe crédit/débit$1,234.56— avec symbole de monnaie
Un convertisseur doit reconnaître et normaliser tous ces éléments en valeurs numériques cohérentes. La mauvaise interprétation d'un séparateur de milliers comme un point décimal (ou vice versa) tourne 1 234,00 $ en 1,234 $ — une erreur mille fois.
Caractères spéciaux et problèmes d'encodage
Les descriptions de transactions peuvent contenir des caractères qui posent problème en PDF :
- Ampersands, apostrophes et caractères accentués dans les noms marchands
- Numéros de référence à contenu alphanumérique mixte
- Caractères des scripts non latins dans les descriptions internationales
L'encodage de texte PDF n'est pas toujours UTF-8. Les anciens PDF peuvent utiliser WinAnsiEncoding, MacRomanEncoding ou des encodages personnalisés. Un convertisseur doit gérer tous ces éléments afin d'éviter les descriptions gaufrées.
Comment les banques produisent leurs PDF
Comprendre comment les banques créent leurs PDF explique une grande partie de la variation dans l'extractibilité.
Création de documents d'entreprise
La plupart des grandes banques utilisent des plateformes de production de documents d'entreprise — des outils comme Ouvrir le texte Exstream, Inspiration du Quadient, ou des systèmes sur mesure. Ces plateformes prennent des données de transaction structurées du système central de la banque et les rendent en format PDF pour la livraison aux clients.
L'ironie n'est pas perdue sur les ingénieurs d'extraction de données : la banque commence par des données parfaitement structurées, les rend dans un format visuel non structuré (PDF), puis le destinataire doit extraire la structure à nouveau. Le PDF est une représentation intermédiaire qui rejette la structure même des données à l'origine.
Variations de mise en page des relevés
Chaque banque (et parfois chaque département au sein d'une banque) fait des choix de conception différents:
| Choix de conception | Variation A | Variation B |
|---|---|---|
| Format de date | MM/JJ/AAAA | DD MMM AAAA |
| Colonnes de montant | Colonne unique (négative pour les débits) | Colonnes de débit et de crédit séparées |
| Colonne de solde | Solde courant par transaction | Solde de fin de journée seulement |
| Description | Ligne unique, tronquée | Multi-ligne avec détails |
| En-têtes de page | Nom de la banque seulement | Informations complètes sur chaque page |
| Total partiel | Aucune | Sous-totals quotidiens, hebdomadaires ou pages |
Un convertisseur qui gère les relevés Chase sans faille peut échouer sur les relevés Bank of America parce que chaque choix de conception diffère.
Comportement du générateur PDF
Le moteur de rendu PDF est également important. Certains générateurs:
- Texte de sortie en chaînes complètes par cellule (plus facile à analyser)
- Caractère texte de sortie par caractère avec positionnement individuel (fort)
- Utiliser des couches de texte invisibles sur les images (communes dans les documents numérisés et-OCR'd)
- Polices intégrées avec des tables d'encodage complètes (extraction de texte fiable) ou sous-ensemble avec des mappages incomplets (non fiables)
- Dessiner des lignes de table en tant que graphiques vectoriels (utiles pour la détection des colonnes) ou n'utiliser aucune bordure visible (enlevant un indice d'analyse)
PDF scannés et numériques : deux problèmes distincts
état de compte bancaire Les PDF sont présentés sous deux formes fondamentalement différentes, et ils présentent des défis d'extraction différents.
PDF numériques (texte)
Les PDF numériques sont générés électroniquement — généralement téléchargés à partir d'un portail bancaire en ligne. Le texte de ces fichiers est stocké comme données de caractère avec des informations de position. Un convertisseur peut lire ce texte directement depuis le flux de contenu.
Pour les PDF numériques, le défi est purement structurel : reconstruire la mise en page du tableau à partir d'un texte positionné. Le texte lui-même est précis et complet.
PDF scannés (images)
Les PDF numérisés sont des photographies de relevés sur papier. Ils contiennent des images raster — grilles de pixels — sans données textuelles. Le flux de contenu contient des opérateurs de dessin d'images, et non des opérateurs de texte.
Pour extraire les données d'un PDF numérisé, un convertisseur doit d'abord exécuter OCR (Optical Character Recognition) pour détecter les régions de texte dans l'image et les convertir en caractères lisibles par machine. Cela ajoute deux modes de défaillance supplémentaires:
-
Erreurs de reconnaissance des caractères — L'OCR peut confondre des caractères semblables : « 0 » et « O », « 1 » et « l » et « I », « 5 » et « S », « 8 » et « B ». Dans les données financières, où une erreur à un seul chiffre change un montant en dollars, cela est particulièrement problématique.
-
Erreurs de détection de la disposition — L'OCR doit déterminer non seulement quels sont les caractères, mais où ils sont positionnés. Des scans asymétriques, une résolution variable et des mises en page complexes peuvent provoquer une mauvaise alignement des blocs de texte du moteur OCR, la fusion de colonnes adjacentes ou le fractionnement de colonnes simples.
Pour obtenir des conseils détaillés sur le traitement des relevés numérisées, consultez notre article sur Conversion des relevés de compte scannés en CSVC'est vrai. Si vous envisagez de numériser plus largement les relevés sur papier, notre guide Comment numériser les relevés de compte bancaires couvre l'ensemble du flux de travail.
Les captures d’écran illustrent une méthode générale, pas des résultats d’extraction vérifiés pour une banque précise.
Le cas hybride
Certains PDF sont hybrides : une image numérisée avec un calque de texte invisible OCR recouvert. L'image est ce que vous voyez ; la couche de texte est ce qu'un convertisseur lit. Si l'OCR a été exécuté par la banque (ou par un système de gestion de documents), la qualité de la couche de texte dépend du moment et de la façon dont l'OCR a été exécuté. Certaines couches de texte OCR sont très précises; d'autres contiennent des erreurs importantes qui sont invisibles pour l'utilisateur qui regarde la page.
Mises en page multicolonnes et ambiguïté visuelle
Les relevés de comptes bancaires utilisent souvent des mises en page multicolonnes qui créent une ambiguïté pour l'extraction automatisée.
Le problème des colonnes débit et crédit
De nombreuses banques utilisent des colonnes de débit et de crédit distinctes plutôt qu'une seule colonne de montant. Visuellement, chaque transaction a un montant dans la colonne de débit ou la colonne de crédit, mais pas les deux. Dans le flux de contenu PDF, la chaîne de montant est positionnée à une coordonnée x spécifique. Un convertisseur doit déterminer si la coordination x tombe dans la colonne débit ou dans la colonne crédit.
Si les en-têtes de colonnes ("Debit" et "Credit") sont présents et clairement positionnés, ce mappage est simple. Si les en-têtes sont manquants, abrégés ou positionnés de manière ambiguë, le convertisseur doit utiliser des indices contextuels — comme si les montants dans la colonne de gauche tendent à diminuer le solde d'exécution.
Récapitulatifs qui ressemblent à des opérations
De nombreux états de compte bancaires comprennent des sections sommaires — totaux quotidiens, moyennes mensuelles, calculs d'intérêts — qui utilisent la même disposition et le même formatage que le tableau des transactions. Un convertisseur qui ne détecte pas et n'exclut pas spécifiquement ces sections comprendra des entrées fallacieuses dans la sortie.
Contenu promotionnel et divulgation
les états de compte bancaires comprennent souvent des mesSages de marketing, des divulgations légales et des termes de compte mélangés avec des données financières. Ces blocs de texte peuvent se situer dans la même zone de page que le tableau des transactions. Un convertisseur doit distinguer entre les données de transaction et le contenu non-transaction, généralement en analysant la structure (ce texte a-t-il une date et une montant?) plutôt que le contenu (qui nécessiterait une compréhension du langage naturel).
Interférences des en-têtes, pieds de page et sauts de page
Les relevés multipages introduisent une complexité supplémentaire.
En-têtes répétés
La plupart des banques répètent les en-têtes de colonnes sur chaque page. Un convertisseur doit reconnaître que le texte « Date Description Montant Solde » apparaissant à la page 3 est un en-tête de page, et non une transaction. Si le convertisseur traite chaque occurrence de ces chaînes d'en-tête comme des données, la sortie contiendra des lignes fallacieuses.
Pieds de page et totaux cumulés
Les pied de page peuvent inclure les totaux courants (« Page Total : 12 345,67 $ »), les résumés de compte ou le texte de pagination (« Page 3 sur 8 »). Ceux-ci apparaissent souvent dans la même zone de la page que la dernière ligne de transaction, créant une ambiguïté quant à l'endroit où la table de transaction se termine et le pied de page commence.
Transactions réparties entre les pages
Une transaction dont la description se rattache à plusieurs lignes peut être divisée en une pause page. La date et la première ligne de la description apparaissent au bas d'une page; la suite de la description apparaît en haut de la page suivante (après l'en-tête répété). Un convertisseur doit s'en charger gracieusement, soit en détectant la continuation et en la fusionnant avec la transaction précédente, soit au moins en ne traitant pas la continuation comme une transaction distincte avec une date et un montant manquants.
Hauteurs variables des pieds de page
Toutes les pages n'ont pas la même hauteur de pied. La dernière page d'un relevé a généralement un pied de page plus long avec des informations de résumé de compte, le texte juridique, et les coordonnées bancaires. Un convertisseur qui utilise une surface de culture fixe pour exclure les pieds de page coupera les transactions sur des pages de pied court ou comprendra du texte de pied de page sur des pages de pied long.
Pourquoi certains formats bancaires sont plus faciles à extraire
Compte tenu de tous les défis ci-dessus, il devrait être clair pourquoi la précision des convertisseurs varie d'une banque à l'autre. Voici les facteurs qui facilitent l'analyse des relevés de certaines banques :
Texte extrait proprement
Les banques dont le PDF génère du texte en tant que chaînes complètes (une chaîne par cellule) sont beaucoup plus faciles à analyser que celles qui produisent du texte caractère par caractère avec un positionnement individuel. La première donne au convertisseur un texte propre et lisible; la seconde nécessite une reconstruction à partir de fragments.
Mises en page cohérentes
Les banques qui utilisent la même disposition pour tous les types de compte et les périodes de relevé sont plus faciles à soutenir que les banques qui varient leur présentation par type de compte (vérification vs épargne vs carte de crédit), période de relevé (mensuelle vs trimestrielle) ou même au fil du temps au fur et à mesure qu'elles mettent à jour leur conception de relevé.
Limites de colonnes claires
Les banques qui dessinent des bordures de table visibles fournissent des limites de colonnes explicites qu'un convertisseur peut détecter. Les banques qui utilisent des tables sans bordures avec seulement l'espace blanc entre les colonnes forcent le convertisseur à déduire les limites du positionnement texte — ce qui fonctionne la plupart du temps mais échoue lorsque les descriptions sont assez longues pour approcher le territoire de la colonne adjacente.
Formatage standard
Les banques qui utilisent des formats de date standard (MM/JJ/AAAA), des formats de numéro standard (1 234,56) et des descriptions monolignes sont plus faciles à analyser que les banques qui utilisent des formats inhabituels, des descriptions multilignes ou des mémos intégrés.
Pas de brouillage
Les banques qui conservent du contenu non-transaction (marketing, divulgations, termes) sur des pages distinctes ou clairement séparées de la table des transactions sont plus faciles à analyser que les banques qui mélangent du contenu promotionnel dans la zone des transactions.
Comment les convertisseurs résolvent ces problèmes
Compte tenu de ces défis, comment les convertisseurs de relevés bancaires fonctionnent-ils réellement?
Approches fondées sur les règles
L'approche traditionnelle utilise des règles artisanales pour chaque format bancaire connu. Le convertisseur identifie la banque (à partir de l'en-tête du relevé), sélectionne l'ensemble approprié de règles (positions de colonne, format de date, format de nombre) et les applique. Cela produit une grande précision pour les banques supportées mais échoue sur des formats inconnus.
Approches d'apprentissage automatique
Certains convertisseurs utilisent des modèles formés pour détecter les structures de la table, identifier les rôles des colonnes et classer les éléments de texte. Cette approche peut mieux gérer les formats inconnus que les systèmes fondés sur des règles pures, mais nécessite de grands ensembles de données de formation et peut produire des erreurs moins prévisibles.
Approches hybrides
La plupart des convertisseurs modernes, y compris LocalExtract, utilisent une combinaison: algorithmes d'analyse de la mise en page à usage général qui fonctionnent sur de nombreux formats bancaires, complétés par une configuration spécifique à la banque pour les formats connus. Cela équilibre la couverture avec précision. Pour un aperçu plus large du fonctionnement des convertisseurs, voir notre Guide complet des convertisseurs de relevés bancaires.
Le défi continu pour les développeurs de convertisseurs est d'élargir la couverture de format tout en maintenant la précision - une tâche qui n'est jamais vraiment "faite" parce que les banques mettent périodiquement à jour leurs conceptions de relevé, introduisant de nouvelles variations de la mise en page que les analyseurs existants peuvent ne pas gérer correctement. Pour un guide pratique du processus de conversion du point de vue de l'utilisateur, voir ce qui est un convertisseur de relevés de compte bancaire.
Perspectives
Le paysage technique de l'extraction des relevés bancaires évolue dans plusieurs directions. Les modèles d'apprentissage automatique sur les appareils deviennent assez puissants pour gérer l'analyse de la disposition sans infrastructure GPU en nuage — un changement qui permet convertisseurs de relevés de compte bancaires hors ligne pour correspondre à la précision du cloud pour la plupart des formats. Des modèles linguistiques de grande envergure sont à l'étude pour comprendre la structure complexe des documents financiers, bien que les exigences de précision des données financières (où une décimale déplacée est une erreur critique) limitent leur applicabilité autonome aujourd'hui. La spécification PDF elle-même continue d'évoluer — ISO 32000-2 a introduit des améliorations à la structure PDF étiquetée — mais l'adoption par les banques de PDF étiquetés pour l'accessibilité reste lente. La tendance la plus marquante est peut-être le passage progressif à la distribution structurée des données (API Open Banking, messagerie ISO 20022) qui pourrait éventuellement réduire la dépendance à l'égard des relevés PDF, bien que cette transition soit mesurée en décennies, et non en années. Pour les comptables et les comptables qui traitent des énoncés PDF d'aujourd'hui, comprendre ces défis de format aide à expliquer pourquoi convertisseurs spécialement conçus pour les petites entreprises existe et pourquoi les outils PDF génériques sont souvent insuffisants.
Questions fréquentes
Pourquoi ne puis-je pas simplement copier et coller à partir d'un PDF ? Lorsque vous copiez du texte à partir d'un PDF, vous obtenez les caractères mais perdez les relations spatiales qui définissent la structure de la table. Le texte de différentes colonnes est concaténé dans l'ordre de lecture, les dates fusionnent avec les descriptions, et les montants perdent leur alignement de colonne. Le résultat est une chaîne non structurée, pas une table.
Qu'est-ce qu'un flux de contenu PDF? Un flux de contenu est la partie d'un PDF qui contient des instructions de dessin — opérateurs qui spécifient le texte à rendre, à quelle position, dans quelle police et taille. Il contient également des opérateurs pour dessiner des lignes, des formes et des images. Les flux de contenu sont la matière première qui convertit l'analyse pour extraire du texte et reconstruire la mise en page.
Pourquoi certains convertisseurs échouent sur les relevés de ma banque ? Le PDF de chaque banque est structuré différemment. Si un convertisseur n'a pas été configuré ou formé pour la mise en page, le format de date, l'arrangement de colonne et le style de sortie de texte de votre banque, il peut fausser les données. Signaler le format non pris en charge au développeur du convertisseur conduit généralement à une meilleure prise en charge dans les mises à jour futures.
Les PDF numérisés sont-ils plus difficiles à convertir que les PDF numériques? Fait significatif. Les PDF numériques contiennent des données textuelles exactes. Les PDF numérisés contiennent des images qui doivent d'abord être traitées par OCR pour récupérer le texte, ajoutant un calque où des erreurs de reconnaissance peuvent se produire. Les scans à basse résolution, les pages biaisées et l'impression effacée réduisent davantage la précision de l'OCR.
L'IA peut-elle résoudre le problème d'extraction PDF ? L'IA et l'apprentissage automatique améliorent la qualité de l'extraction, en particulier pour le traitement des mises en page inconnues et des documents numérisés. Cependant, les données financières exigent une précision quasi parfaite (un point décimal déplacé modifie un montant en dollars d'un facteur de 10), et les modèles actuels d'IA n'atteignent pas systématiquement ce niveau de précision pour tous les types de documents. Les approches hybrides qui combinent l'analyse fondée sur les règles et la détection de la mise en page basée sur le ML produisent actuellement les résultats les plus fiables.
Comment LocalExtract fait-il face à ces défis? LocalExtract utilise un moteur d'extraction à base de rouille avec PDFium pour l'extraction de texte et PP-OCRv5 pour les documents numérisés. Il utilise une analyse de la mise en page générale complétée par une configuration spécifique à la banque pour les formats connus. Le traitement se fait entièrement sur votre appareil (macOS et Windows), en gardant vos données privées — voir notre convertisseur de relevé de compte bancaire privé guidez pourquoi cela compte. Le volet gratuit couvre 10 pages; le plan Pro est de 10 $ par mois ou 60 $ par année.
LocalExtract convertit les fichiers PDF de l'état de compte en CSV pour une utilisation dans Excel entièrement sur votre appareil — aucun envoi, aucun traitement cloud, aucun accès de tiers à vos données financières. Disponible pour macOS et Windows.
LocalExtract Team
Nous développons LocalExtract, un convertisseur de relevés pour ordinateur. Questions ou corrections ? Contact · Politique éditoriale