
Daten aus einem PDF-Kontoauszug extrahieren
Aktualisiert · 16 Min. Lesezeit
Kernaussagen
- PDF-Kontoauszüge enthalten keine Tabellen — sie enthalten positionierte Textelemente, die optisch Tabellen ähneln. Das Extrahieren strukturierter Daten erfordert das Rekonstruieren von Zeilen und Spalten aus Koordinaten.
- Open-Source-Python-Bibliotheken wie Tabula, pdfplumber und Camelot können Transaktionsdaten programmatisch extrahieren, aber jeder behandelt Kantenfälle unterschiedlich und erfordert eine Abstimmung pro Bankformat.
- Cloud-Extraktionsdienste bieten Komfort, erfordern aber das Hochladen sensibler Finanzdaten auf Server von Drittanbietern – eine Berücksichtigung für Profis, die an die FTC Safeguards-Regel gebunden sind.
- On-device-Tools verarbeiten PDFs lokal ohne Netzwerkzugriff, halten Kontonummern, Bilanzen und Transaktionshistorien auf Ihrem Rechner.
- Jede Extraktionsmethode erfordert einen Prüfschritt. Der Vergleich der extrahierten Summe mit den gedruckten Summen der Kontoauszug ist der schnellste Weg, um fehlende oder duplizierte Transaktionen zu fangen.
Transparenzhinweis: Dieser Artikel stammt vom LocalExtract-Team. Wir entwickeln den Desktop-Konverter und haben ein wirtschaftliches Interesse an diesem Thema. Vergleichen Sie die exportierten Zeilen mit Ihrem eigenen Kontoauszug. Bankanleitungen und allgemeine Screenshots sind keine Kompatibilitätsgarantien.
Extrahieren von Daten aus einem PDF-Kontoauszug klingt, wie es einfach sein sollte. Die Transaktionen liegen genau dort — Daten, Beschreibungen, Beträge, Salden — in ordentlichen Zeilen und Spalten. Lies einfach den Tisch.
Das Problem ist, dass es keinen Tisch gibt. Ein PDF ist ein Seitenbeschreibungsformat für den Druck, nicht für den Datenaustausch. Was wie eine Tabelle auf dem Bildschirm aussieht, ist eigentlich eine Sammlung von individuell positionierten Textfragmenten. Die PDF-Datei sagt "Ziehen Sie die Zeichenkette '03/07/2026' bei Koordinaten (72, 540)" und "Ziehen Sie '-150.00' bei Koordinaten (480, 540)." Ihre Augen sehen eine Reihe. Die Datei sieht keinen Text.
Dieser Artikel umfasst fünf Extraktionsmethoden – von manueller Kopierpasta über Open-Source-Python-Bibliotheken bis hin zu On-Device-Tools – mit Arbeitscode-Beispielen und einem Überprüfungsworkflow. Wenn Sie nur brauchen, Konvertieren Sie einen PDF-Kontoauszug in CSV, dieser Führer deckt den schnellsten Weg. Dieser Artikel geht tiefer in Warum Extraktion ist hart und wie jede Methode mit den Kantenfällen umgeht.
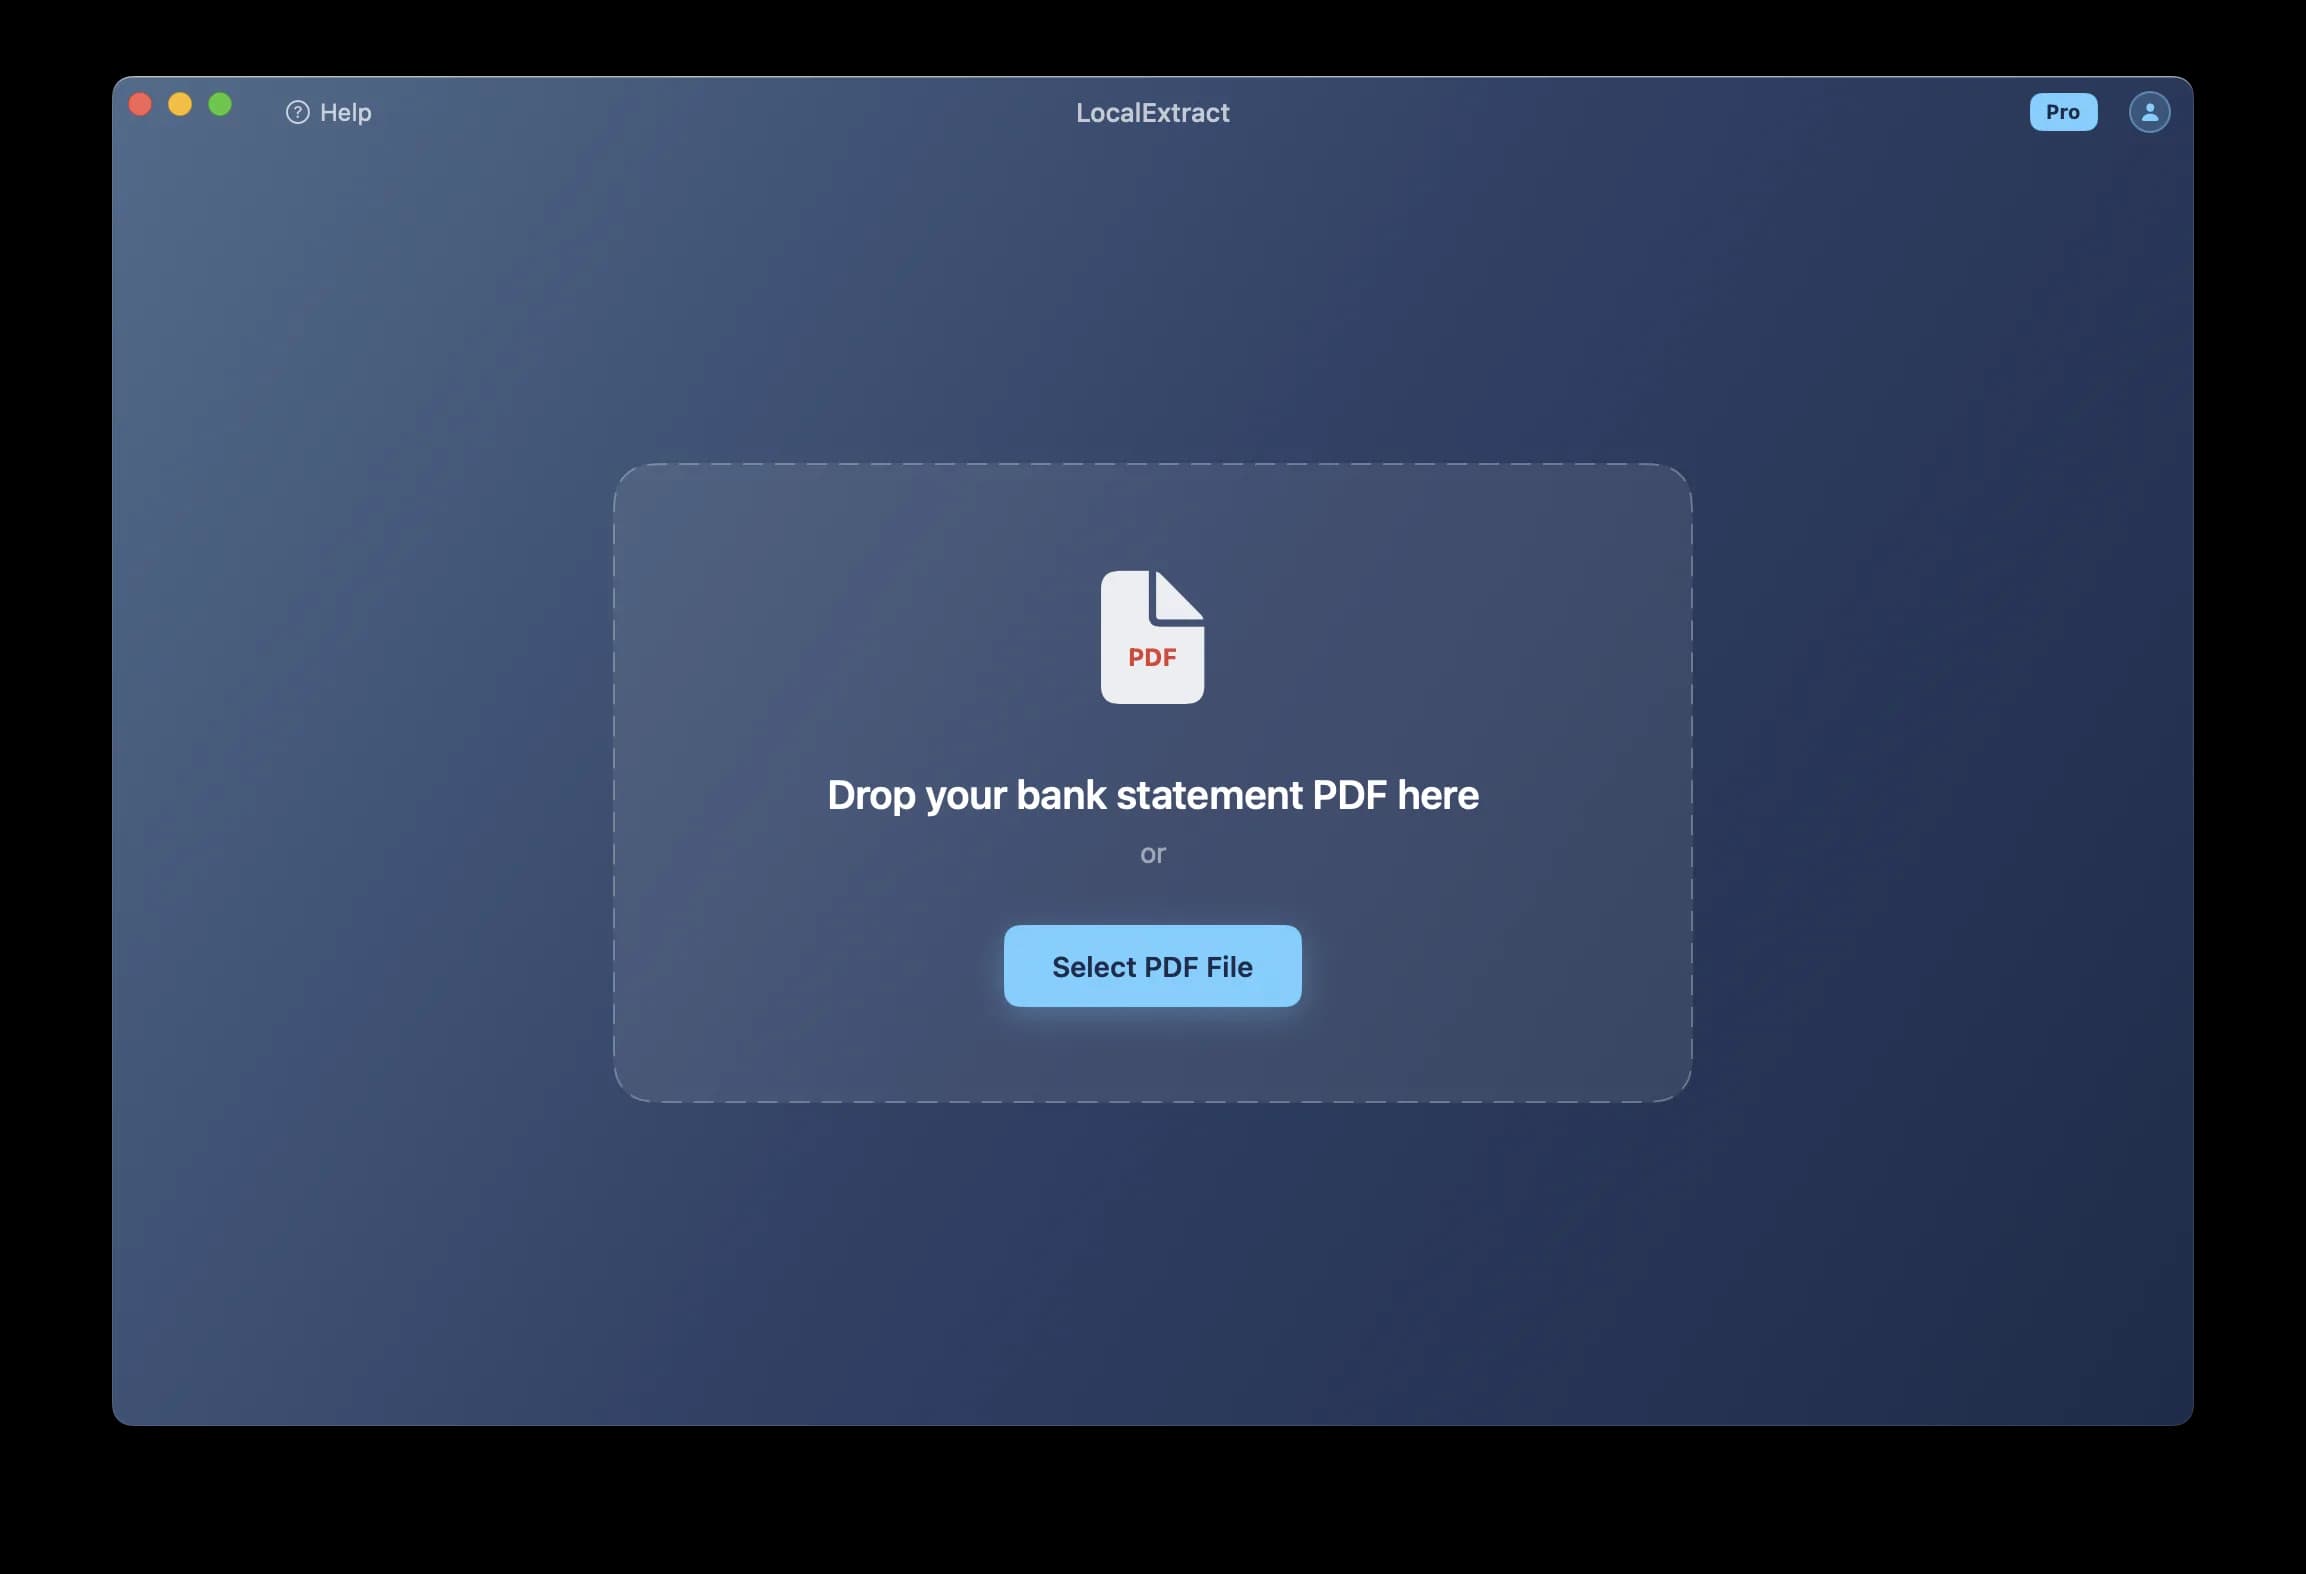
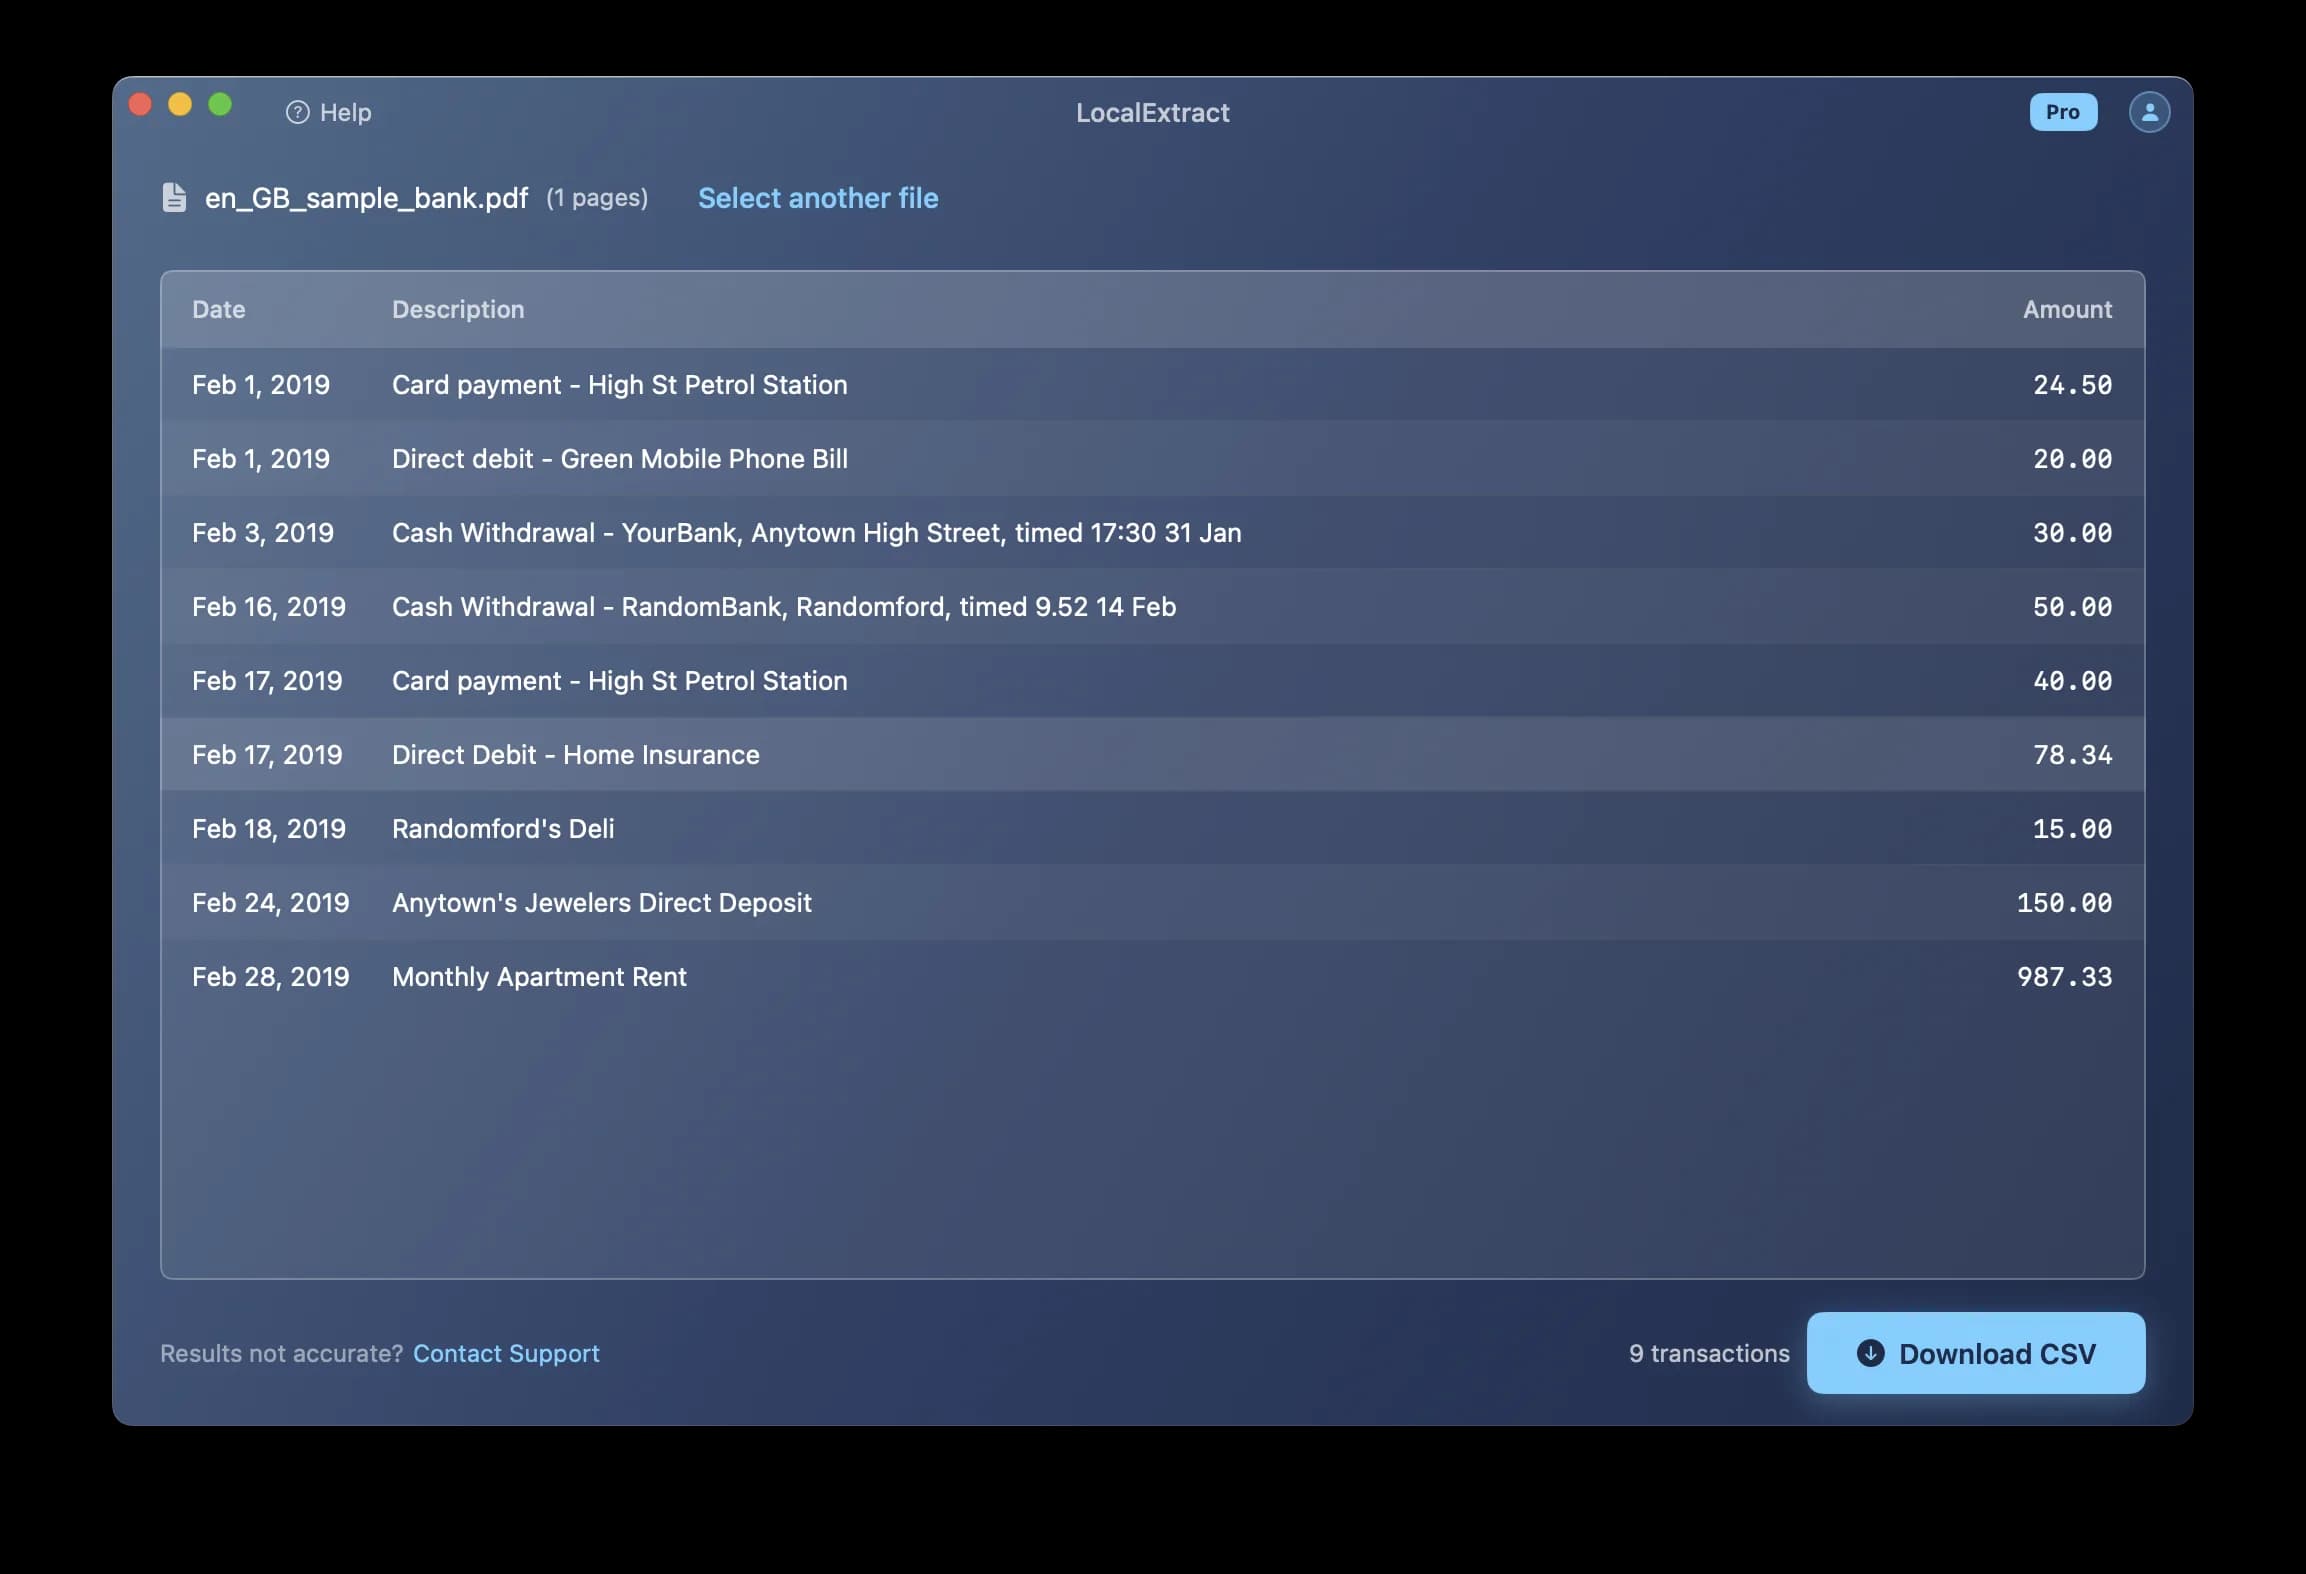
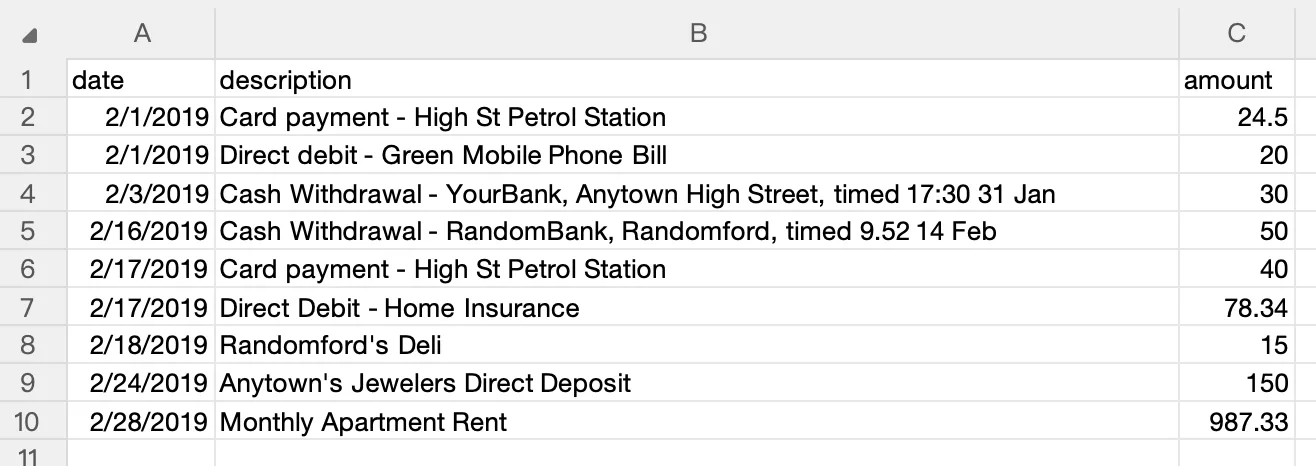
Funktionsumfang der LocalExtract-Desktop-App: Exportieren Sie jeweils ein ausgewähltes PDF als CSV mit den Spalten
date,descriptionundamount. Öffnen Sie die CSV-Datei in Excel und speichern Sie sie dort bei Bedarf als XLSX. Die App bietet keine Stapelwarteschlange, keinen Export als JSON, QBO oder OFX und keine Synchronisierung mit Buchhaltungssoftware. PDF-Analyse und OCR laufen lokal. Für Konto-, Abonnement- und Aktualisierungsdienste ist eine Internetverbindung erforderlich, einschließlich der regelmäßigen Pro-Verifizierung. Testen Sie Ihren eigenen Kontoauszug und prüfen Sie jede Zeile: Eine unterstützte Sprache oder eine Anleitung zu einer Bank garantiert nicht die Kompatibilität mit jedem Auszugsformat.
Die Desktop-Apps exportieren Datum, Beschreibung und Betrag als CSV. Öffnen Sie die CSV in Excel und speichern Sie dort eine XLSX-Datei. Prüfen Sie das Ergebnis anhand Ihres eigenen PDFs; die Unterstützung hängt vom Auszugsformat ab.
Warum die Datenextraktion aus PDFs schwierig ist
Vor der Wahl einer Methode hilft es zu verstehen, warum dieses Problem besteht. PDF-Extraktion ist kein gelöstes Problem — es ist eine Reihe von Heuristiken, die gut in gemeinsamen Fällen funktionieren und in Randfällen scheitern.
Keine Tabellenstruktur in der Datei. Ein PDF speichert keine Tabellen-Metadaten. Es gibt kein "table" Objekt, kein "row" Objekt, kein "cell" Objekt. Die Datei enthält Zeichnungsanweisungen: Platzieren Sie diesen Textstring an diese (x, y) Koordinaten, zeichnen Sie eine Linie von Punkt A nach Punkt B. Um eine Tabelle zu extrahieren, muss die Software das Layout umkehren, indem sie Textelemente gruppiert, die dieselbe vertikale Position in Zeilen teilen und Spaltengrenzen aus der horizontalen Ausrichtung bestimmen.
Die Screenshots zeigen allgemeine Arbeitsabläufe, keine überprüften Extraktionsergebnisse für eine bestimmte Bank.
Mehrseitige Tabellen. Kontoauszüge über mehrere Seiten routinemäßig. Die Extraktionssoftware muss Tabellenfortschritte erkennen, wiederholte Header überspringen, Seitenfußzeilen ignorieren und Daten zusammenheften. Ein einziger verpasster Seitenbruch kann Header als Datenzeilen duplizieren oder Transaktionen fallen lassen.
Mehrzeilige Beschreibungen. Einige Banken teilen Transaktionsdetails über zwei Zeilen auf — die Beschreibung auf einer Zeile, eine Prüfnummer oder einen Referenzcode auf der nächsten. Extraktionssoftware muss erkennen, dass die zweite Zeile zur ersten Transaktion gehört, nicht dass es sich um eine separate Transaktion mit fehlenden Feldern handelt.
Gescannt gegen digitale PDFs. Digitale PDFs enthalten aktuelle Textzeichen. Gescannte PDFs sind Bilder ohne Textdaten, die OCR (Optical Character Recognition) als Vorverarbeitungsschritt erfordern. Moderne OCR-Engines erreichen bei sauberen Dokumenten eine Genauigkeit von über 99%, aber selbst eine Fehlerrate von 0,5% kann Dollarbeträge verfälschen oder Ziffern in Kontonummern transponieren. Für einen Durchlauf der Handhabung gescannter Kontoauszüge speziell, siehe wie man einen gescannten Kontoauszug in CSV konvertiert.
Methode 1: Manuelles Kopieren und Einfügen
Am besten für: Einseitige Kontoauszüge, einmalige Aufgaben, Kontoauszüge mit weniger als 20 Transaktionen.
Der einfachste Ansatz: Öffnen Sie das PDF, wählen Sie die Transaktionstabelle aus, kopieren Sie es und fügen Sie es in eine Tabellenkalkulation ein.
Schritte:
- Öffnen Sie das PDF in jedem Viewer (Vorschau, Adobe Acrobat, Chrome).
- Wählen Sie die Transaktionszeilen aus. Versuchen Sie, nur die Tabelle auszuwählen, nicht Kopfzeilen, Fußzeilen oder Kontozusammenfassungen.
- Kopieren (Strg+C / Cmd+C).
- Einfügen in eine Tabelle (Excel, Google Sheets).
- Aufräumen: Spaltenausrichtung beheben, leere Zeilen entfernen, Daten und Beträge neu formatieren.
- Exportieren Sie als CSV oder verwenden Sie direkt in der Tabelle.
Einschränkungen: Spaltenausrichtung ist nach dem Einfügen oft falsch. Die Beträge können in der Spalte „Beschreibung" angelandet werden. Mehrzeilige Beschreibungen können über Reihen verteilt werden. Für mehrseitige Kontoauszüge wiederholen Sie diesen Vorgang für jede Seite und kombinieren die Ergebnisse manuell. Erwarten Sie 10-30 Minuten pro Kontoauszug, mit einem sinnvollen Risiko von Transkriptionsfehlern auf jedem Pass.
Methode 2: Open-Source Python-Bibliotheken
Am besten für: Entwickler und technisch geneigte Nutzer, die Kontoauszüge programmatisch verarbeiten, volle Kontrolle über die Extraktionslogik wünschen oder Extraktion in eine automatisierte Pipeline integrieren müssen.
Mehrere Open-Source-Python-Bibliotheken können tabellarische Daten aus PDFs extrahieren. Die drei am häufigsten verwendeten sind Tabula, pdfplumber und Camelot. Jeder nimmt eine andere Herangehensweise an das Problem.
Tabula (Tabula-py)
Tabula verwendet eine Java-basierte Extraktions-Engine (umwickelt für Python), die Tabellen erkennt, indem sie die räumliche Anordnung von Textelementen analysiert. Es unterstützt zwei Modi: "lattice" (verwendet sichtbare Linien/Grenzen, um Tabellen zu finden) und "stream" (verwendet Textausrichtung, wenn keine Grenzen existieren).
import tabula

# Extract all tables from a bank statement
tables = tabula.read_pdf(
    "statement.pdf",
    pages="all",
    multiple_tables=True,
    stream=True  # Use stream mode for borderless tables
)

# The first table is usually the transaction table
transactions = tables[0]
transactions.to_csv("transactions.csv", index=False)
Tabula funktioniert gut, wenn das PDF konsistenten Spaltenabstand und sauberen Text hat. Es kämpft mit PDFs, wo Spalten in der Nähe zusammen sind oder wo Beträge variable Formatierung haben (einige mit Dollarzeichen, einige ohne).
pdfplumber
pdfplumber bietet Ihnen Zugriff auf die Position, Größe und Schriftart jedes einzelnen Textelements. Dies macht es flexibler als Tabula — Sie können benutzerdefinierte Logik schreiben, um Randfälle zu handhaben — aber es bedeutet auch mehr Code.
import pdfplumber
import csv

with pdfplumber.open("statement.pdf") as pdf:
    all_rows = []
    for page in pdf.pages:
        # Extract table with custom settings
        table = page.extract_table({
            "vertical_strategy": "text",
            "horizontal_strategy": "text",
            "snap_y_tolerance": 5,
            "intersection_x_tolerance": 15
        })
        if table:
            all_rows.extend(table)

# Write to CSV
with open("transactions.csv", "w", newline="") as f:
    writer = csv.writer(f)
    writer.writerow(["Date", "Description", "Amount", "Balance"])
    for row in all_rows:
        if row[0] and row[0].strip():  # Skip empty rows
            writer.writerow(row)
pdfplumbers Stärke ist Konfigurierbarkeit. Das snap_y_tolerance und intersection_x_tolerance Parameter können Sie einstellen, wie aggressiv die Bibliothek Gruppen Text in Zeilen und Spalten. Das Tradeoff ist, dass optimale Einstellungen von Bank zu Bank unterschiedlich sind — ein Chase-Statement kann andere Toleranzen erfordern als eine Wells Fargo-Statement.
Camelot
Camelot ist speziell für die Tabellenextraktion (nicht allgemeine PDF-Textextraktion) konzipiert. Wie Tabula unterstützt es Gitter- und Streammodi, bietet aber auch für jede erkannte Tabelle einen Genauigkeitsscore, der Ihnen hilft, die Extraktionsqualität programmatisch zu bewerten.
import camelot

# Extract tables using stream mode (for borderless tables)
tables = camelot.read_pdf(
    "statement.pdf",
    flavor="stream",
    pages="all",
    edge_tol=50,
    row_tol=10
)

# Check accuracy for each table
for i, table in enumerate(tables):
    print(f"Table {i}: {table.parsing_report['accuracy']}% accuracy")

# Export the best table
if len(tables) > 0:
    tables[0].to_csv("transactions.csv")
Praktische Überlegungen für Python-Bibliotheken
Diese Bibliotheken funktionieren gut für einmalige Extraktionen, aber der Produktionseinsatz beinhaltet laufende Arbeiten: per-Bank-Tuning (jede Bank Formate Kontoauszüge unterschiedlich), mehrseitige Stiche (Bearbeitung wiederholter Kopfzeilen und Seitenumbrüche), Nachbearbeitung (Stripping Dollar Zeichen, Umwandlung (150.00) zu -150.00, Datumsanalyse) und Wartung, wenn Banken ihre Statement-Layouts umgestalten.
Methode 3: Cloud-basierte Extraktionsdienste
Am besten für: Benutzer, die hohe Genauigkeit wollen, ohne Code zu schreiben und komfortabel Finanzdokumente auf einen Server von Drittanbietern hochladen.
Cloud-basierte Dienste nutzen die serverseitige Verarbeitung – oft kombiniert sie PDF-Analyse mit maschinellen Lernmodellen –, um strukturierte Daten aus Kontoauszügen zu extrahieren. Sie laden das PDF hoch, der Service verarbeitet es und laden Ergebnisse als CSV, Excel oder JSON herunter.
Beispiele sind Amazon Textract, Google Document AI, Azure Form Recognizer und spezialisierte Dienste für Finanzdokumente.
Diese Dienste bieten eine hohe Genauigkeit (vor allem bei gängigen US-Bankformaten), behandeln sowohl digitale als auch gescannte PDFs und benötigen keinen Code. Der Tradeoff ist, dass Sie den Kontoauszug – einschließlich Kontonummern, Guthaben und Transaktionshistorien – auf einen entfernten Server hochladen müssen. API-basierte Dienste berechnen auch pro Seite oder Dokument, und Sie hängen von den Preis- und Datenspeicherungsrichtlinien des Anbieters ab.
Methode 4: Tabellenwerkzeuge auf dem Desktop
Am besten für: Benutzer arbeiten bereits in Excel oder Google Sheets, die eine schnelle Extraktion benötigen, ohne zusätzliche Software zu installieren.
Sowohl Microsoft Excel als auch Google Sheets bieten begrenzte PDF-Importfunktionen.
In Excel, gehen Sie zu Daten > Daten abrufen > aus Datei > aus PDF. Excel erkennt Tabellen und lässt sie per Power Query laden. Dies funktioniert für einfache, einseitige Tabellen mit klaren Grenzen, scheitert aber häufig mit mehrseitigen Tabellen und grenzenlosen Layouts, die typisch für Kontoauszüge sind.
Google Sheets importiert nicht nativ PDFs, aber Sie können das PDF auf Google Drive hochladen und wählen Mit > Google Docs öffnen Um OCR zu leiten. Die Tabellenstruktur geht in der Regel bei der Konvertierung verloren, was eine manuelle Reinigung in Platten erfordert.
Methode 5: Extraktionswerkzeuge mit lokaler Verarbeitung
Am besten für: Profis, die eine genaue Extraktion aus verschiedenen Bankformaten benötigen, ohne sensible Finanzdaten hochzuladen, und die ein gebrauchsfertiges Tool ohne Schreiben oder Aufrechterhaltung von Code wünschen.
On-Device-Extraktionstools sind Desktop-Anwendungen, die PDFs lokal verarbeiten. Die Datei verlässt niemals Ihren Rechner, es wird keine Internetverbindung benötigt und kein Dritter greift auf den Inhalt des Dokuments zu. Diese Tools kombinieren PDF-Textextraktion, Layoutanalyse, OCR und Bankformat-spezifische Logik zu einer einzigen Anwendung – die Per-Bank-Tuning und Post-Processing, die Python-Bibliotheken dem Benutzer überlassen, sind eingebaut.
LocalExtract ist ein solches Werkzeug. Es läuft auf macOS und Windows, verwendet eine Rust-basierte Engine mit PDFium zur Textextraktion und PP-OCRv5 für gescannte Dokumente und exportiert CSV von der Desktop-Schnittstelle. Die kostenloser Tarif umfasst insgesamt 10 Seiten. Der Pro-Plan ($10/Monat oder $60/Jahr) entfernt die Seitengrenzen.
Weitere On-Device-Tools sind MoneyThumb (spezialisiert auf QBO-Ausgabe) und verschiedene Desktop PDF-to-Excel Konverter.
Vergleich der fünf Methoden
Die folgenden Ratings basieren auf dem Test unseres Teams in 12 US-Bankkontoauszugsformaten (Chase, Bank of America, Wells Fargo, Citi, US Bank, Capital One, PNC, TD Bank, Truist, Regions, Huntington und Fifth Third) mit einmonatigen Statements von 2 bis 15 Seiten. "Per-Statement Time" misst die Zeit der Wanduhr vom Eingang bis zum nutzbaren CSV, einschließlich einer manuellen Reinigung. "Accuracy" spiegelt die Richtigkeit der Transaktions-Ebene wider, die durch vollständige Abstimmung mit den gedruckten Gesamtsummen der Kontoauszug überprüft wurde.
| Verfahren | Einrichtungszeit | Per-Statement-Zeit | Genauigkeit | Verwendet gescannte PDFs | Privatsphäre |
|---|---|---|---|---|---|
| Manuelle Kopie einfügen | Keine | 10-30 min | Kommt auf die Pflege an. | Nein | Vollständig (lokal) |
| Python Bibliotheken | 1-4 Stunden | Sekunden (nach Abstimmung) | Hoch für abgestimmte Formate | Nein (erfordert separate OCR) | Vollständig (lokal) |
| Cloud-Dienste | Protokoll | Sekunden | Hoch für gängige Formate | Ja | Auf Dritte hochgeladene Daten |
| Tabellenkalkulationswerkzeuge | Keine | 5-15 Min. | Niedrigmittelwert | Teilweise (Google Drive OCR) | Verschiedene nach Plattform |
| Geräte-Werkzeuge | Protokoll | Sekunden | Hoch für unterstützte Formate | Ja (falls das Werkzeug OCR einschließt) | Vollständig (lokal) |
Nicht sicher, welche Kategorie passt zu Ihrem Workflow? Unser Überblick über was ein Kontoauszug-Konverter ist erklärt die Landschaft im Detail.
Wie Sie extrahierte Daten überprüfen können
Verifizieren Sie immer extrahierte Daten, bevor Sie sie für die Buchhaltung oder Berichterstattung verwenden. Extraktionsfehler können sich über Ihr Buchhaltungssystem verbreiten.
Schritt 1: Zeilenzählprüfung
Zählen Sie Transaktionen in Ihren extrahierten Daten und vergleichen Sie mit dem Original-PDF. Wenn das PDF 47 Transaktionen zeigt und Ihr CSV 45 Zeilen hat, wurden zwei gelöscht.
Schritt 2: Summenabgleich
Summen Sie die Beträge in Ihren extrahierten Daten und vergleichen Sie mit den gedruckten Gesamtsummen der Kontoauszug (Gesamteinlagen, Gesamtabhebungen oder Endsaldo). Eine passende Summe bedeutet, dass die Extraktion jede Transaktion korrekt erfasst hat.
import csv
from decimal import Decimal

with open("transactions.csv") as f:
    reader = csv.DictReader(f)
    total = sum(Decimal(row["Amount"]) for row in reader)

print(f"Extracted total: {total}")
# Compare this against the statement's printed net change
Schritt 3: Sonderfälle stichprobenartig prüfen
Prüfen Sie manuell einige spezifische Transaktionen:
- Die ersten und letzten Transaktionen auf jeder Seite (Seitengrenzen sind, wo Extraktionsfehler Cluster).
- Jede Transaktion mit einer ungewöhnlich langen Beschreibung (mehrzeilige Beschreibungen sind anfällig für Spaltung oder Beschneidung).
- Die größte Transaktion nach Betrag (wenn die großen Zahlen stimmen, sind die kleinen in der Regel auch).
Datenschutz und Compliance Überlegungen
Kontoauszüge enthalten sensible Finanzdaten: Kontonummern, Routing-Nummern, Transaktionshistorien, Salden und Ausgabenmuster. Wie Sie diese Daten während der Extraktion behandeln – sowohl ethisch als auch rechtlich.
Das FTC Safeguards Rule Finanzinstitutionen und bestimmte professionelle Dienstleister, einschließlich Steuerausstellern, Buchhaltern und Buchhaltern, sind verpflichtet, Sicherheitsvorkehrungen für die Finanzinformationen der Kunden durchzuführen. Das California Consumer Privacy Act (CCPA) zusätzliche Anforderungen für in Kalifornien tätige Unternehmen.
Lokale Verarbeitung (copy-paste, Python-Bibliotheken, on-device-Tools) speichert Daten auf Ihrem Rechner. Cloud-Verarbeitung übermittelt Dokumente an einen entfernten Server — überprüfen Sie vor dem Hochladen die Datenschutzrichtlinie des Dienstes und die Aufbewahrungsfrist der Daten. Für Fachleute, die Finanzdaten von Kunden im Rahmen regulatorischer Verpflichtungen verarbeiten, beseitigen lokale Verarbeitungsmethoden eine ganze Kategorie von Compliance-Fragen.
LocalExtract: Fähigkeiten und Einschränkungen
LocalExtract ist das Tool, das unser Team baut, und wir wollen transparent sein, was es gut macht und wo es kurz fällt.
Was es gut macht: Prozesse digitale und gescannte PDFs (in PP-OCRv5 OCR eingebaut), bearbeitet Multi-Seiten-Tabellen automatisch, exportiert dreispaltige CSV für die Verwendung in Excel, verarbeitet Dokumente on-device auf macOS und Windows; Konto-, Abonnement- und Updatedienste nutzen das Internet.
Einschränkungen:
- Die Abdeckung des Bankformats ist nicht universell. Funktioniert am besten mit US-Bankformaten. Nicht-US-Banken oder stark maßgeschneiderte Corporate-Banking-Portale können unvollständige Ergebnisse liefern.
- Keine QBO- oder IIF-Ausgabe. Wenn Ihr Workflow QBO-Format erfordert, sind Werkzeuge wie MoneyThumb eine bessere Passform.
- OCR hängt von der Scanqualität ab. Niedrigauflösende Scans, verdrehte Seiten oder Dokumente mit handschriftlichen Annotationen liefern Ergebnisse in geringerer Qualität.
- Kostenloser Tarif ist begrenzt. insgesamt 10 Seiten — genug, um zu bewerten, aber Pro ($10 / Monat oder $60 / Jahr) ist für die regelmäßige Verwendung erforderlich.
- Keine Batch-API. Nur Desktop-Anwendung. Für die automatisierte Pipeline-Verarbeitung ist eine Python-basierte oder API-basierte Lösung geeigneter.
Fazit
Das Extrahieren von Daten aus einem PDF-Kontoauszug ist schwieriger, als es aussieht, weil das Dateiformat für den Druck konzipiert wurde, nicht für den Datenaustausch. Die richtige Extraktionsmethode hängt von Ihrem Volumen, Ihrem technischen Komfort und Ihren Datenschutzanforderungen ab. Für eine einmalige Aufgabe arbeitet Copy-Paste. Bei wiederkehrenden Extraktionen mit voller Kontrolle geben Ihnen Python-Bibliotheken Flexibilität auf Kosten der per-bank-Tuning. Für Hands-off Genauigkeit ohne Hochladen sensibler Daten, on-device-Tools behandeln die Kantenfälle -- mehrseitige Tabellen, gescannte Dokumente, bankspezifische Formatierung -- also müssen Sie nicht. Welche Methode Sie auch wählen, überprüfen Sie immer: Vergleichen Sie Ihre extrahierten Gesamtsummen mit den gedruckten Gesamtsummen der Kontoauszug, bevor die Daten in Ihr Buchhaltungssystem eingegeben werden.
Häufige Fragen
Was ist der einfachste Weg, um Daten aus einem PDF-Kontoauszug zu extrahieren? Für eine einzelne Kontoauszug ist manuelles Kopieren in eine Tabellenkalkulation die einfachste Methode — keine zu installierenden Werkzeuge, keine Konten zu erstellen. Für alles, was über eine einmalige Aufgabe hinausgeht, spart ein On-Device-Extraktionstool erhebliche Zeit und reduziert das Risiko von manuellen Fehlern. Die richtige Methode hängt davon ab, wie viele Kontoauszüge Sie verarbeiten und wie oft.
Kann ich mit Python Kontoauszugsdaten extrahieren? Doch. Bibliotheken wie Tabula, pdfplumber und Camelot können tabellarische Daten aus digitalen PDFs extrahieren. Sie benötigen Code, um bankspezifische Formatierung, mehrseitige Tabellen und Nachbearbeitung zu handhaben. Die Codebeispiele in diesem Artikel sind funktionale Ausgangspunkte.
Brauche ich OCR, um Daten aus einem PDF-Kontoauszug zu extrahieren? Nur wenn das PDF gescannt wird (ein Bild der Kontoauszug anstatt eines digitalen Dokuments mit wählbarem Text). Sie können dies testen, indem Sie versuchen, Text aus dem PDF auszuwählen und zu kopieren. Ist Text wählbar, wird kein OCR benötigt. Wenn sich das PDF wie ein Bild verhält, benötigen Sie OCR. Werkzeuge wie Tesseract (Open Source) oder kommerzielle OCR-Dienste können gescannte PDFs vor der Extraktion in Text umwandeln.
Wie genau ist die automatisierte PDF-Datenextraktion? Für digitale PDFs mit sauberer Formatierung erreichen automatisierte Extraktionstools typischerweise eine sehr hohe Genauigkeit – oft über 99% auf Transaktionsebene für unterstützte Bankformate. Für gescannte PDFs hängt die Genauigkeit von der Scanqualität und der verwendeten OCR-Engine ab. Unabhängig von der Methode, überprüfen Sie immer extrahierte Daten mit den gedruckten Gesamtsummen der Kontoauszug, bevor Sie sie für die Buchhaltung verwenden.
Ist es sicher, Kontoauszüge auf einen Cloud-Extraktionsdienst hochzuladen? Cloud-Dienste erfordern die Übermittlung Ihres Kontoauszuges – einschließlich Kontonummern, Guthaben und Transaktionsdetails – an einen entfernten Server. Ob dies akzeptabel ist, hängt von Ihren Datenschutzanforderungen, regulatorischen Verpflichtungen und den Datenschutzrichtlinien des Dienstes ab. Für Profis, die an die FTC Safeguards Rule gebunden sind, ist der einfachste Compliance-Pfad, eine lokale Verarbeitungsmethode zu verwenden, die Daten auf Ihrer eigenen Maschine speichert.
Welche Ausgabeformate kann ich aus der PDF-Extraktion bekommen? Die häufigsten Ausgänge sind CSV, Excel (XLSX) und JSON. CSV ist die universellste für Buchhaltungssoftwareimporte - siehe unseren Leitfaden zu Kontoauszug CSV-Format für die Buchhaltung für Spaltenkonventionen, die QuickBooks, Xero und Wave erwarten. Excel bewahrt die Formatierung und unterstützt mehrere Blätter. JSON ist nützlich für die programmatische Verarbeitung. Die meisten Extraktionswerkzeuge unterstützen mindestens CSV.
Wie handle ich Kontoauszüge mit mehreren Konten auf demselben PDF? Einige Banken kombinieren mehrere Konten in einem einzigen PDF. Automatisierte Tools können alle Transaktionen in eine einzige Ausgabe extrahieren und Konten miteinander vermischen. Filtern Sie nach der Extraktion nach Kontonummer oder Kontoname, um sie zu trennen.
Warum fehlen meine extrahierten Daten oder zusätzliche Zeilen? Fehlende Zeilen ergeben sich in der Regel aus mehrseitigen Tabellenbrüchen oder Transaktionen in einem unerwarteten Format. Zusätzliche Zeilen stammen in der Regel von wiederholten Headern, die als Daten behandelt werden oder nicht-Transaktionslinien (Subgesamte, Abschnitt Header) enthalten sind. Überprüfen Sie, indem Sie Ihre Zeilenanzahl und Summen mit der ursprünglichen Kontoauszug vergleichen.
Transparenzhinweis: Dieser Artikel stammt vom LocalExtract-Team. Wir entwickeln den Desktop-Konverter und haben ein wirtschaftliches Interesse an diesem Thema. Vergleichen Sie die exportierten Zeilen mit Ihrem eigenen Kontoauszug. Bankanleitungen und allgemeine Screenshots sind keine Kompatibilitätsgarantien.
LocalExtract Team
Wir entwickeln LocalExtract, einen Kontoauszug-Konverter für den Desktop. Fragen oder Korrekturen? Kontakt · Redaktionsrichtlinien