
Gescannte Kontoauszüge mit OCR in CSV umwandeln
Aktualisiert · 16 Min. Lesezeit
Kernaussagen
- Gescannte Kontoauszüge sind imagebasierte PDFs, die OCR (Optical Character Recognition) erfordern, bevor Daten extrahiert werden können — Standard-PDF-Parser können sie nicht lesen.
- Die OCR-Genauigkeit hängt von Scanqualität, Auflösung (300 DPI Minimum) und Dokumentbedingung ab. Selbst die besten OCR-Motoren sind nicht 100% genau, daher ist eine manuelle Überprüfung unerlässlich.
- Es gibt drei OCR-Ansätze: Open Source (Tesseract), Cloud-based (Google Vision, AWS Textract) und On-Device (LocalExtract verwendet PP-OCRv5). Jedes beinhaltet unterschiedliche Kompromisse in Genauigkeit, Privatsphäre und Kosten.
- Gescannte Kontoauszüge enthalten oft Unterschriften, handgeschriebene Notizen und Stempel — diese Elemente tragen zusätzliche Datenschutzrisiken, wenn sie in Cloud-Dienste hochgeladen werden.
- Bessere Scan-Praktiken (hoher DPI, flache Platzierung, saubere Originale) verbessern direkt die OCR-Genauigkeit und reduzieren den Zeitaufwand für manuelle Korrekturen.
Transparenzhinweis: Dieser Artikel stammt vom LocalExtract-Team. Wir entwickeln den Desktop-Konverter und haben ein wirtschaftliches Interesse an diesem Thema. Vergleichen Sie die exportierten Zeilen mit Ihrem eigenen Kontoauszug. Bankanleitungen und allgemeine Screenshots sind keine Kompatibilitätsgarantien.
Buchhaltungsfachkräfte erhalten regelmäßig Kontoauszüge als gescannte PDFs — fotokopierte Seiten, Handyaufnahmen oder Faxdokumente, die als PDF-Dateien gespeichert werden. Im Gegensatz zu digital generierten PDFs aus dem Online-Banking sind diese gescannten Kontoauszüge Bilder, die in einen PDF-Container eingewickelt werden. Sie können den Text nicht auswählen, Transaktionen kopieren oder einen Standard-PDF-to-CSV-Konverter ohne OCR verwenden.
Diese Anleitung erläutert OCR, Einflussfaktoren auf die Genauigkeit, verfügbare Werkzeuge und die Umwandlung gescannter Kontoauszüge in eine nutzbare CSV-Datei.
Funktionsumfang der LocalExtract-Desktop-App: Exportieren Sie jeweils ein ausgewähltes PDF als CSV mit den Spalten
date,descriptionundamount. Öffnen Sie die CSV-Datei in Excel und speichern Sie sie dort bei Bedarf als XLSX. Die App bietet keine Stapelwarteschlange, keinen Export als JSON, QBO oder OFX und keine Synchronisierung mit Buchhaltungssoftware. PDF-Analyse und OCR laufen lokal. Für Konto-, Abonnement- und Aktualisierungsdienste ist eine Internetverbindung erforderlich, einschließlich der regelmäßigen Pro-Verifizierung. Testen Sie Ihren eigenen Kontoauszug und prüfen Sie jede Zeile: Eine unterstützte Sprache oder eine Anleitung zu einer Bank garantiert nicht die Kompatibilität mit jedem Auszugsformat.
Die Desktop-Apps exportieren Datum, Beschreibung und Betrag als CSV. Öffnen Sie die CSV in Excel und speichern Sie dort eine XLSX-Datei. Prüfen Sie das Ergebnis anhand Ihres eigenen PDFs; die Unterstützung hängt vom Auszugsformat ab.
Textbasierte PDFs vs. Gescannte PDFs: Was ist der Unterschied?
Diese Unterscheidung zu verstehen ist entscheidend, weil sie bestimmt, welche Umwandlungsmethode funktioniert.
Textbasierte PDFs werden digital generiert. Wenn die Website Ihrer Bank eine Kontoauszug herunterladen kann, enthält PDF aktuelle Textdaten – Zeichen, Koordinaten und Schriftinformationen. Sie können Text auswählen, nach Schlüsselwörtern suchen und Transaktionen kopieren. Diese PDFs konvertieren mit Standard-Extraktionswerkzeugen zuverlässig in CSV.
Gescannte PDFs (bildbasiert) Fotos von gedruckten Seiten enthalten. Wenn jemand eine Kontoauszug durch einen Scanner ausführt, ein Telefonfoto macht oder ein Fax empfängt, speichert das resultierende PDF Pixeldaten – ein Bild von Text, nicht Text selbst. Es gibt keine Zeichen zu wählen und keine Daten zu kopieren.
Einige PDFs fallen dazwischen. Ein mit OCR-Software verarbeitetes gescanntes Dokument kann eine unsichtbare Textebene hinter dem Bild enthalten. Diese "suchbaren PDFs" verhalten sich wie textbasierte PDFs zur Extraktion, obwohl die Textebene Fehler aus dem ursprünglichen OCR-Pass enthalten kann.
Die Screenshots zeigen allgemeine Arbeitsabläufe, keine überprüften Extraktionsergebnisse für eine bestimmte Bank.
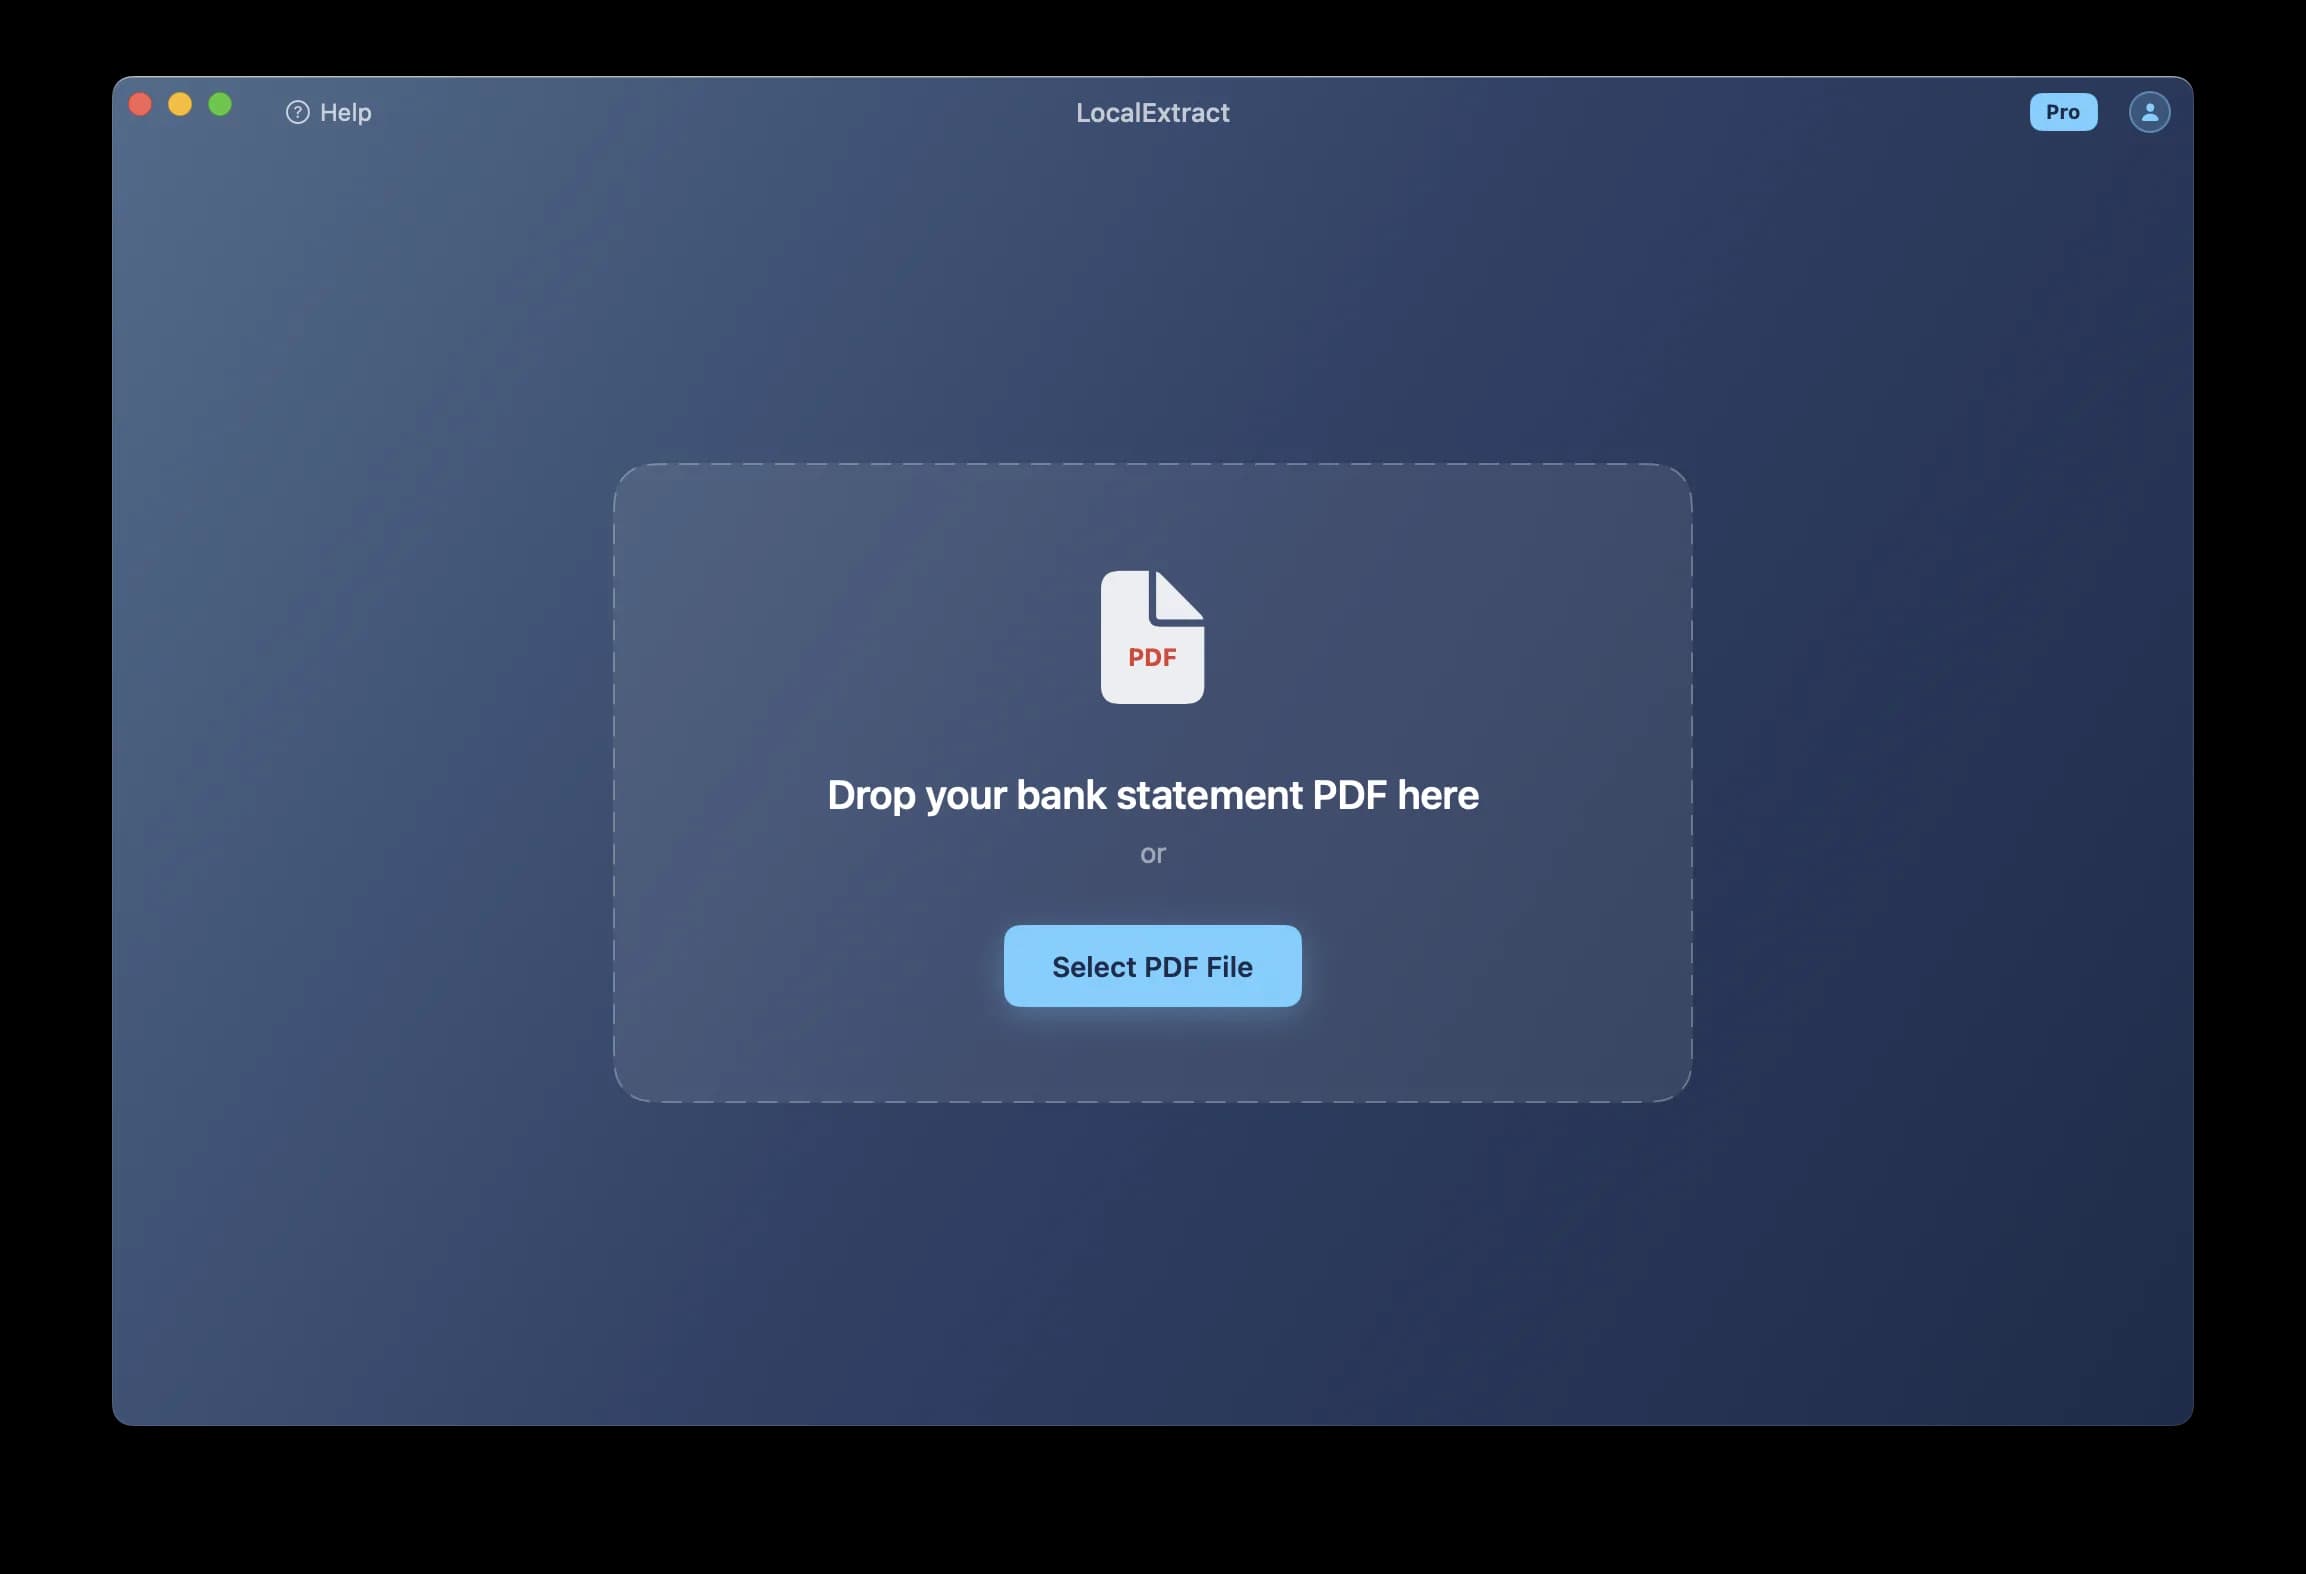
Einen breiteren Überblick über die Umwandlung von Papier und digitalen Kontoauszüge in strukturierte Daten finden Sie in unserem Leitfaden zu wie man Kontoauszüge digitalisiert.
Was ist OCR und wie funktioniert es?
OCR steht für Erkennung optischer Zeichen. Es ist die Technologie, die Bilder von Text in maschinenlesbare Zeichen umwandelt. Bei der Anwendung auf eine gescannte Kontoausweisung analysiert OCR die Pixelmuster im Bild, identifiziert Formen, die Buchstaben und Zahlen entsprechen, und gibt den erkannten Text aus.
Moderne OCR-Systeme arbeiten in mehreren Phasen: Bildvorbehandlung (beeinträchtigende verdrehte Scans, Geräuschentfernung, Kontrastanpassung), Texterkennung (Identifizieren von Regionen, die Text enthalten und sie von Logos, Grenzen und Leerzeichen trennen), Zeichenerkennung (entdeckte Zeichen mit ausgebildeten Deep-Learning-Modellen kombinieren) und Nachbearbeitung (Refining der Ergebnisse anhand von Sprachmodellen und kontextuellen Regeln — z.B. Korrektur O zu 0 In einer numerischen Spalte).
Die Ausgabe ist strukturierter Text, der dann in Felder (Datum, Beschreibung, Betrag) parsiert und in eine CSV-Datei geschrieben werden kann. Für einen detaillierten Durchlauf der Extraktion strukturierter Daten aus gescannten und digitalen PDFs siehe wie man Daten aus der PDF-Kontoauszüge extrahiert.
Faktoren für die OCR-Genauigkeit
OCR ist kein Binär-Pass-oder-Fail-Prozess. Die Genauigkeit der Ausgabe hängt von mehreren Faktoren ab, und das Verständnis dieser hilft Ihnen, realistische Erwartungen zu setzen und Schritte zu unternehmen, um die Ergebnisse zu verbessern.
Scanauflösung (DPI)
DPI (dots per inch) ist der wichtigste Faktor. Höhere Auflösung bedeutet mehr Pixeldaten für die OCR-Engine zum Arbeiten.
| DPI | Qualität | OCR Eignung |
|---|---|---|
| 72-100 | Bildschirmauflösung | Schlechte — Zeichen sind verschwommen, hohe Fehlerrate |
| 150 | Druck niederer Qualität | Marginal — kann für große Schriftarten funktionieren, unzuverlässig für kleinen Text |
| 200 | Standardfaxqualität | Akzeptiert für saubere Dokumente, Kämpfe mit Feindruck |
| 300 | Standard-Scanqualität | Gut — empfohlenes Minimum für OCR |
| 600 | Qualitativ hochwertiger Scan | Ausgezeichnet — beste Genauigkeit, größere Dateigrößen |
Das Richtlinien für die digitale Bewahrung der Bibliothek des Kongresses empfehlen 300 DPI als Minimum für die OCR-Verarbeitung.
Zustand von Dokument und Scan
Körperliche Defekte wirken sich direkt auf die OCR-Genauigkeit aus: Falten und Falten durch Text, Kaffeeflecken, verblasste Tinte (üblich in dot-matrix gedruckten Kontoauszüge) und vergilbtes Papier reduzieren die Erkennungsqualität. Der Scan-Prozess fügt seine eigenen Herausforderungen hinzu: verzerrte Ausrichtung, Schatten aus gebundenen Broschüren, ungleichmäßige Beleuchtung in Telefonaufnahmen und Bewegungsunschärfe.
Schriftart und Layout
Standard serif und sans-serif Schriftarten (Times New Roman, Arial) werden mit hoher Genauigkeit erkannt. Dot-Matrix-Druck, handschriftlicher Text und sehr kleine Schriftarten sind schwieriger. Kontoauszüge erfordern auch die Erkennung von Tabellenstrukturen – die OCR-Engine muss Spaltengrenzen identifizieren, Werte mit den korrekten Spalten verknüpfen und Transaktionszeilen von Headern und Subtotalen unterscheiden.
OCR-Werkzeuge zur Umwandlung von Kontoauszügen
Es stehen drei Kategorien von OCR-Tools mit jeweils unterschiedlichen Eigenschaften zur Verfügung. (Für einen breiteren Vergleich von Konversionswerkzeugen über OCR hinaus siehe was ist ein Kontoauszug-Konverter.)
Open Source OCR: Tesseract
Tesseract ist die am weitesten verbreitete Open-Source OCR-Engine. Ursprünglich von HP in den 1980er Jahren entwickelt und später von Google gepflegt, nutzt Tesseract 5 ein LSTM neuronales Netzwerk zur Charaktererkennung und unterstützt über 100 Sprachen.
Tesseract ist kostenlos, läuft lokal und unterstützt viele Sprachen. Sie führt jedoch nur die Zeichenerkennung durch — sie versteht die Dokumentenstruktur nicht. Sie erhalten Rohtextausgabe, keine strukturierten Tabellendaten, so dass die Umwandlung dieser Ausgabe in einen korrekt formatierten CSV zusätzliche Programmierung erfordert. Genauigkeit bei degradierten Scans ist geringer als kommerzielle Alternativen. Tesseract ist eine gute Wahl für Entwickler, die eine benutzerdefinierte Pipeline bauen, aber es ist keine gebrauchsfertige Lösung für Buchhalter.
Cloud-basierte OCR-Dienste
Cloud OCR-Dienste verarbeiten Dokumente auf Remoteservern und liefern strukturierte Ergebnisse zurück. Die wichtigsten Optionen sind: Google Cloud Vision API (Dokumenttexterkennung mit Layoutanalyse, ~$1.50 pro 1.000 Seiten), Amazon Textract (strukturierte Tabellen- und Formularextraktion, ~$15 pro 1.000 Seiten für Tabellen) und Microsoft Azure AI Dokumentenintelligenz (vorgefertigte Modelle für Finanzdokumente mit individueller Schulung verfügbar).
Cloud-OCR-Dienste bieten hohe Genauigkeit (insbesondere bei anspruchsvollen Dokumenten), integrierte Tabellenstrukturerkennung und kontinuierliche Modellverbesserungen. Die Kompromisse: Ihre Kontoauszugsdaten werden an Server von Drittanbietern übermittelt, die Preise pro Seite addieren sich für die regelmäßige Nutzung, und die Datenspeicherungsrichtlinien variieren je nach Anbieter.
OCR auf dem eigenen Gerät
On-Device OCR läuft die Erkennungs-Engine lokal auf Ihrem Computer. Es werden keine Daten an externe Server übermittelt.
LocalExtract verwendet PP-OCRv5 (PaddlePaddle OCR-Version 5) läuft durch ONNX Runtime für On-Device OCR. PP-OCRv5 wurde von Baidus PaddlePaddle-Team entwickelt und ist eines der genaueren Open-Source-OCR-Modelle verfügbar, mit starker Leistung sowohl auf Englisch und mehrsprachigen Text. Mit ONNX Runtime kann das Modell effizient auf Standard-CPUs laufen, ohne dass eine GPU benötigt wird.
Wenn Sie eine gescannte Kontoauszug in LocalExtract öffnen, erkennt die Anwendung imagebasierte Inhalte, führt die OCR-Pipeline aus und gibt eine CSV-Datei aus – die gleichen Formate, die Sie von einem textbasierten PDF erhalten. On-device OCR vermeidet das Hochladen von Scans auf einen Conversion-Provider und verursacht keine API-Gebühren pro Seite. Die Gerätesicherheit spielt weiterhin eine Rolle, und Konto- und Abonnementdienste können Internetzugang erfordern. Die Kompromisse: Genauigkeit kann niedriger sein als Cloud-Dienste bei anspruchsvollen Dokumenten, und Modellaktualisierungen erfordern Anwendungsupdates.
Gescannte Kontoauszüge in CSV umwandeln: Schritt für Schritt
Hier ist der allgemeine Workflow für die Konvertierung eines gescannten Kontoauszuges in CSV, unabhängig davon, welches Tool Sie verwenden.
Schritt 1: Scanqualität beurteilen
Öffnen Sie das PDF und vergrößern Sie auf 100%. Wenn der Text nicht scharf und lesbar für Ihre Augen ist, wird die OCR-Engine zu kämpfen. Überprüfen Sie nach Skew, Schatten und Flecken über den Transaktionsdaten. Wenn die Scan-Qualität schlecht ist und Sie das ursprüngliche Papierdokument haben, wird das Re-Scannen bei 300 DPI zu besseren Ergebnissen führen als die Verarbeitung eines qualitativ minderwertigen Scans.
Schritt 2: OCR ausführen
- Tesseract (Befehlszeile):
tesseract statement-page.png output --oem 1 -l eng pdferzeugt ein durchsuchbares PDF, aber Sie benötigen zusätzliche Werkzeuge, um den Text in CSV-Format zu lesen. - Cloud OCR (API): Laden Sie das Dokument über die API des Anbieters hoch. Dienste wie AWS Textract liefern strukturierte Tabellendaten, die in CSV-Spalten gemappt werden können.
- LocalExtract (Desktop-App): Öffnen Sie das gescannte PDF in der Anwendung. Es erkennt automatisch imagebasierte Inhalte, führt PP-OCRv5 OCR aus und extrahiert Transaktionen. Als CSV exportieren.
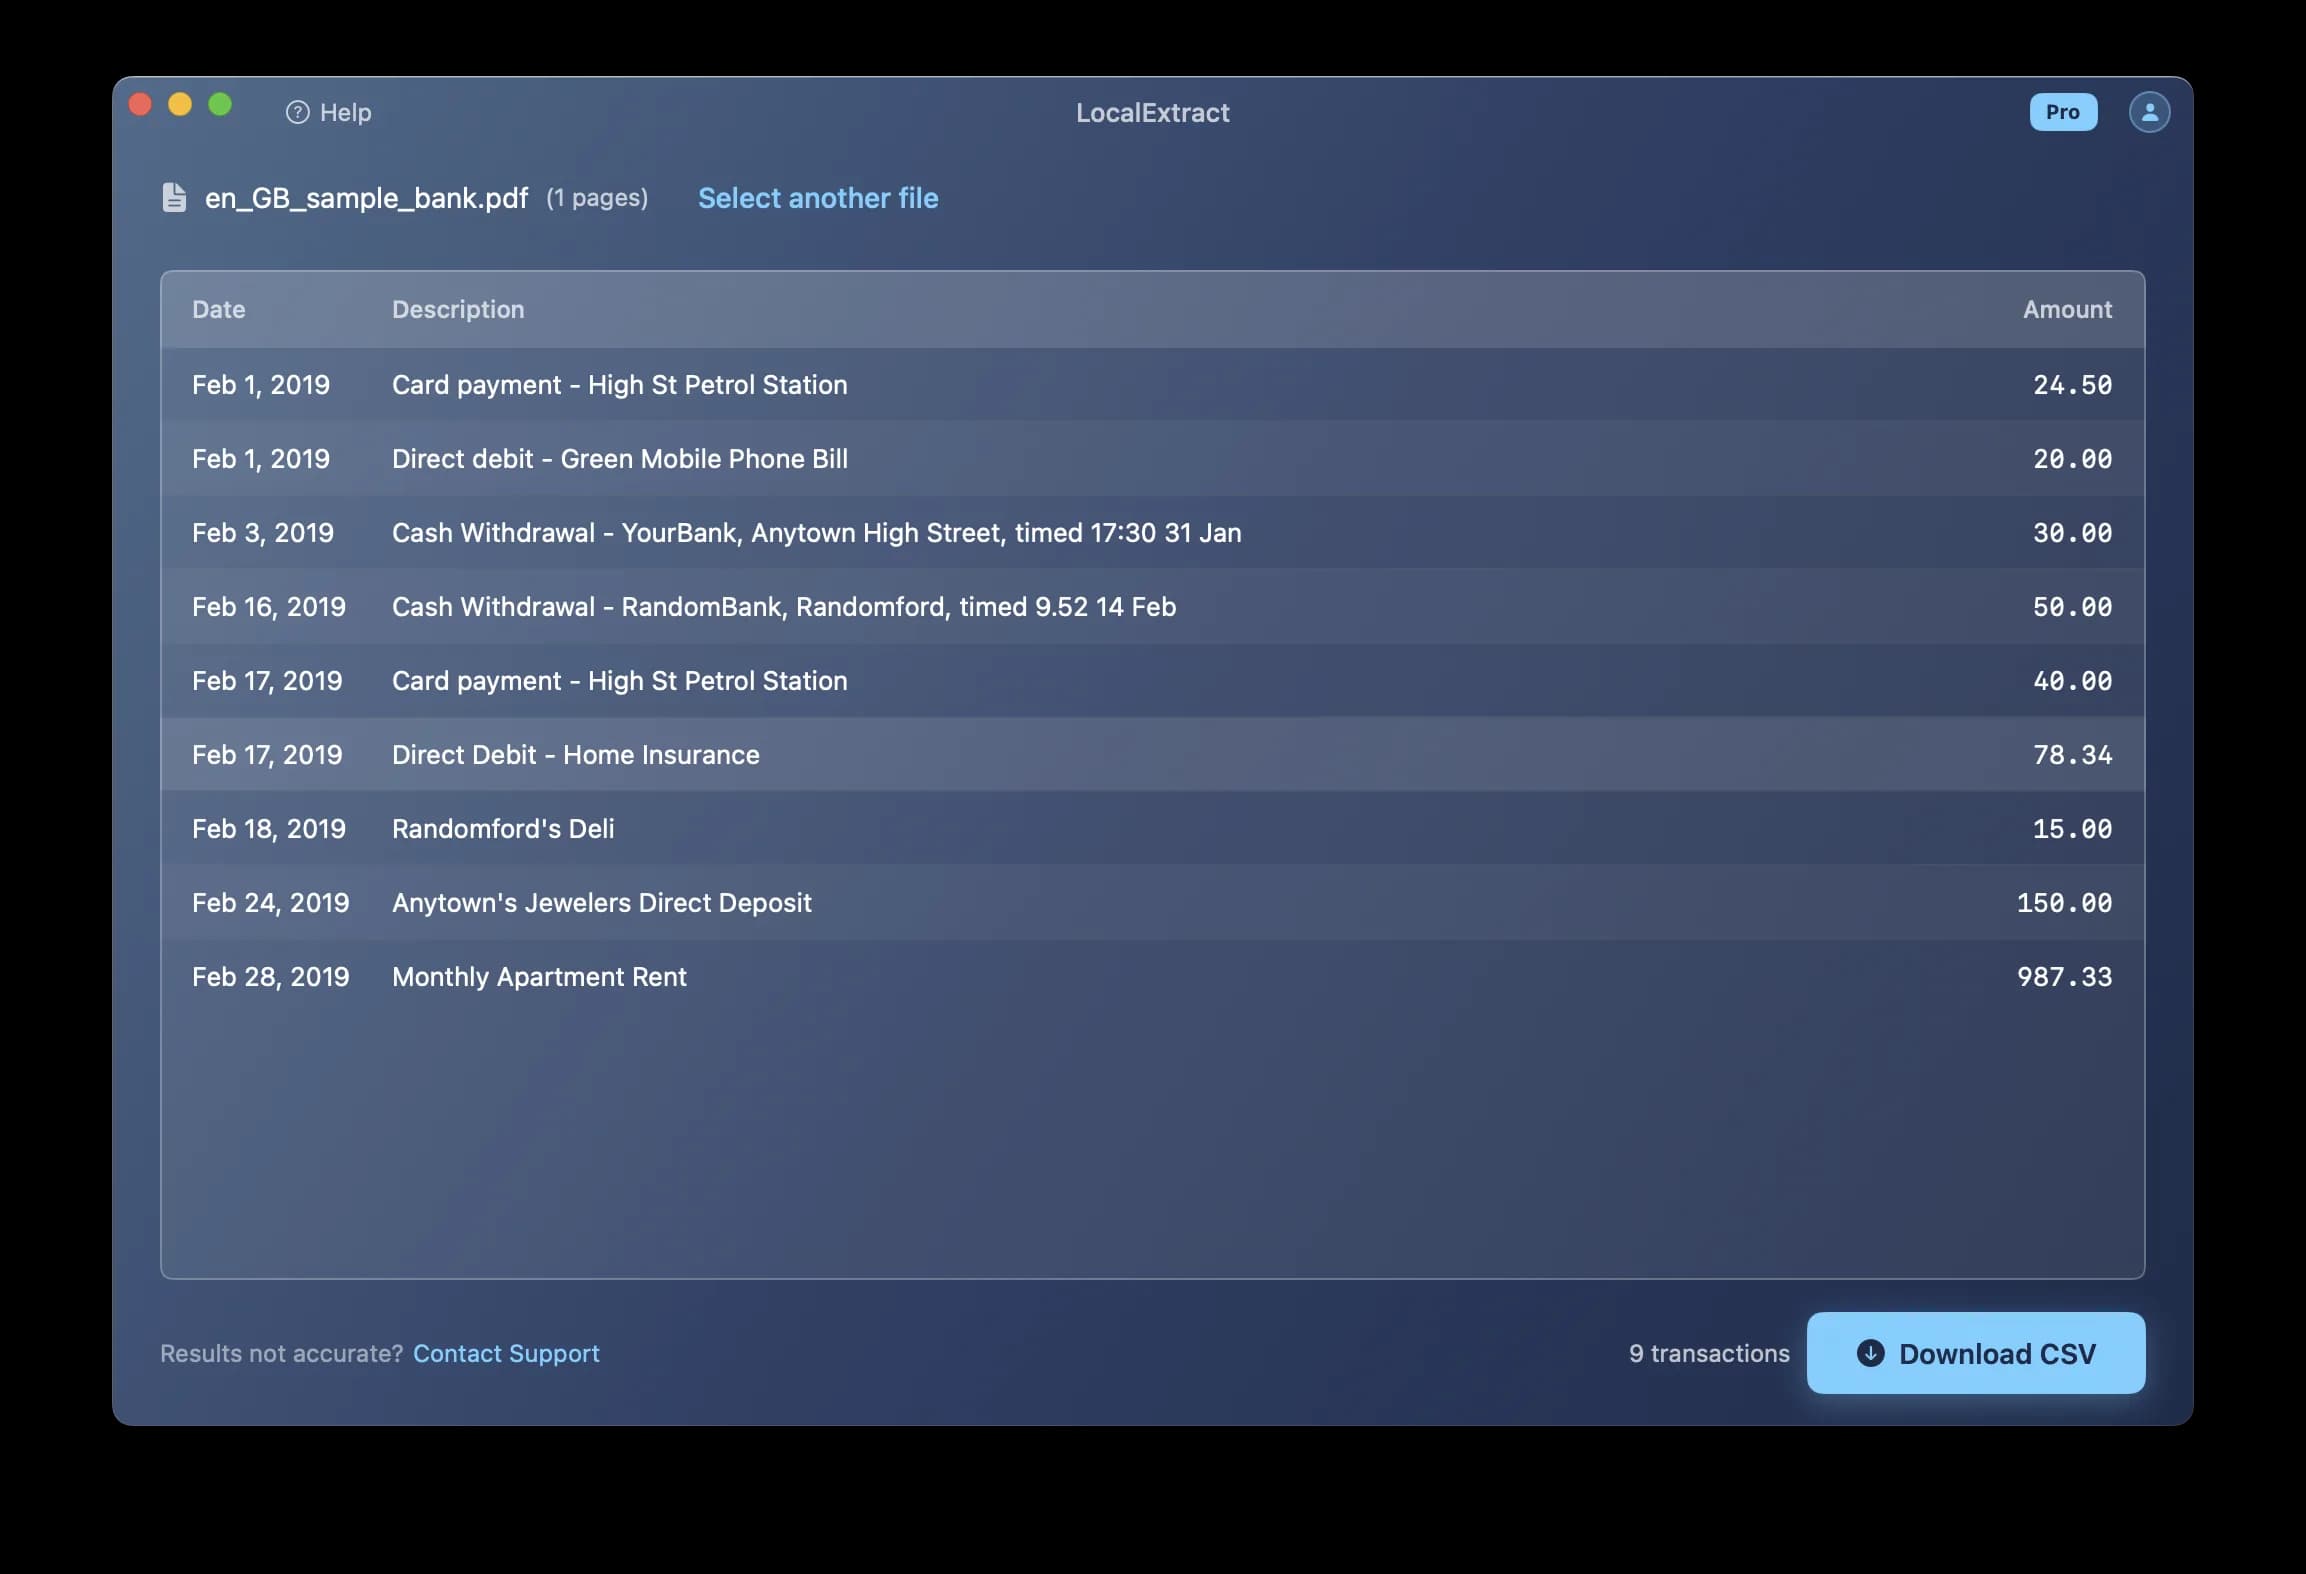
Wenn Ihr PDF nicht gescannt, sondern textbasiert ist, ist der Prozess einfacher -- siehe unsere Anleitung auf wie man PDF-Kontoauszüge in CSV umwandelt für diesen Workflow.
Schritt 3: Prüfen und abgleichen
Bevor Sie den CSV-Daten vertrauen, überprüfen Sie die Ausgabe auf häufige OCR-Fehler: Zeichenverwirrung (0 gegen O, 5 gegen S, 8 gegen B), zusammengelegte oder geteilte Beträge, Datumsfehler und fehlende Transaktionen. Prüfen Sie dann mit dem Original – vergleichen Sie Transaktionszählungen, Buchungssummen mit Kontoauszügen und überprüfen Sie die Anfangs- und Endsalden.
Schritt 4: Fehler korrigieren und exportieren
Beheben Sie OCR-Fehler, formatieren Sie dann den CSV für Ihre Buchhaltungssoftware: Verifizieren Sie das Datumsformat (MM/DD/YYY für QuickBooks), entfernen Sie Währungssymbole und Tausendertrennzeichen und stellen Sie sicher, dass die Spaltenbestellung mit dem übereinstimmt, was Ihre Software erwartet.
Scanempfehlungen für bessere OCR-Ergebnisse
Wenn Sie den Scanvorgang steuern — selbst Papieranweisungen scannen oder Kunden über das Scannen beraten — werden diese Praktiken die OCR-Genauigkeit sinnvoll verbessern.
Auflösung: Scannen bei 300 DPI mindestens. Wenn die Kontoauszug kleine Schriftarten hat (üblich in Transaktionsdetails), wird 400-600 DPI die Genauigkeit verbessern.
Platzierung: Legen Sie die Seite flach und gerade auf das Scannerbett. Selbst ein 2-3 Grad skew zwingt den OCR-Motor zur Ausführung von Schreibtischarbeiten, die Artefakte einführen können. Wenn das Scannen von einem gebundenen Booklet, drücken Sie die Bindung flach, um Wirbelsäule Schatten zu vermeiden.
Farbmodus: Grayscale ist die beste Balance aus Qualität und Dateigröße. Es bewahrt Text-zu-Hintergrund-Kontrast ohne den Overhead von Farbdaten. Schwarz und Weiß (1-Bit) kann für saubere Originale arbeiten, zerstört aber tonale Informationen, die mit degradierten Text hilft.
Telefonkamera-Scanning: Verwenden Sie eine dedizierte Scan-App (Microsoft Lens, Adobe Scan, Apple Notes) und nicht die Standardkamera - diese Apps wenden automatisch perspektivische Korrektur und Kontrastanpassung an. Legen Sie das Dokument auf eine flache, gut beleuchtete Oberfläche und halten Sie das Telefon direkt darüber. Eine vollständige Übersicht über die Umwandlung von Papierkontoauszügen in digitale Formate (einschließlich CSV und Excel) finden Sie in unserem Leitfaden zu wie man PDF-Kontoauszüge in CSV umwandelt.
Warum die Verifizierung nicht verhandelbar ist
Bei einem sauberen, 300 DPI Scan können moderne OCR-Motoren eine Genauigkeit von 95-99% erreichen. Dieser Bereich basiert auf veröffentlichten Benchmarks: PaddleOCRs PP-OCRv4 meldet 78,8% Genauigkeit auf herausfordernde Szenentext-Datensätze (mit einer weiteren Verbesserung von PP-OCRv5), während Tesseract erreicht 95-99% auf sauber gedruckten Dokumenten unter kontrollierten Bedingungen. Aber eine einzige Kontoauszugsseite könnte 2.000 Zeichen enthalten. Bei 99% Genauigkeit, das sind 20 falsch erkannte Zeichen. Es gibt keine Rechtschreibprüfung auf Zahlen -- 1,500.00 und 1,800.00 sind beide gültige Beträge, so dass ein falscher 5 als 8 ist ohne Referenzdaten nicht nachweisbar.
Behandeln Sie OCR-Ausgabe als Entwurf, der überprüft werden muss, nicht als Endprodukt.
Datenschutzbestimmungen für gescannte Dokumente
Gescannte Kontoauszüge verdienen im Vergleich zu digital generierten PDFs eine erhöhte Aufmerksamkeit bei der Privatsphäre. Eine fotokopierte Kontoauszug kann handschriftliche Notizen, Unterschriften, Briefmarken und sogar angrenzende Dokumente (Steuerformulare, Ausweiskopien) enthalten, wenn Seiten in Stapel gescannt wurden. Eine gescannte Kopie kann eine Fotokopie der Unterschrift des Kontoinhabers oder eine handschriftliche Sozialversicherungsnummer am Rand enthalten.
Wenn Sie eine gescannte Kontoauszug in einen Cloud-OCR-Dienst hochladen, werden all diese Inhalte – nicht nur die Transaktionsdaten – an die Server des Anbieters übertragen. Die OCR-Engine verarbeitet das gesamte Bild, und der Dienst kann das Dokument gemäß seiner Datenspeicherungsrichtlinie behalten. Das FTC Safeguards Rule verlangt von Finanzfachleuten angemessene Garantien für Kundeninformationen. Die Verarbeitung von Dokumenten über Cloud-Dienste ist nicht verboten, aber sie schafft zusätzliche Anforderungen an Dienstleister und Datenübermittlung. Lokale Verarbeitung vermeidet diese Übermittlung; Gerätesicherheit, Zugriffsrechte, Aufbewahrung und anwendbare Datenschutzpflichten bleiben relevant.
On-device OCR Tools verarbeiten das gescannte Bild lokal. Das Dokument, die OCR-Analyse und die extrahierten Daten bleiben auf Ihrem Computer. Es erfolgt keine Netzwerkübertragung und kein Dritter hat Zugriff auf die Inhalte.
Grenzen von LocalExtract
LocalExtract behandelt viele gescannte Kontoauszug Szenarien, aber es ist nicht das richtige Werkzeug für jede Situation:
- Die OCR-Genauigkeit variiert je nach Scanqualität. Bei degradierten Scans (niedrige Auflösung, schwere Skew, verblasste Tinte) können Genauigkeitstropfen und Cloud-OCR-Dienste mit größeren Modellen besser funktionieren.
- Handgeschriebener Text wird nicht unterstützt. Handgeschriebene Einträge werden übersprungen oder produzieren unzuverlässige Ausgabe.
- Nicht alle Banklayouts werden unterstützt. LocalExtract umfasst viele US-Banken, aber nicht jedes Format. Nicht unterstützte Layouts können teilweise oder mit Strukturfehlern extrahieren.
- Keine QBO- oder IIF-Ausgabe. Es wird nur CSV unterstützt. QBO- oder IIF-Workflows erfordern ein anderes Tool.
- Langsamer auf gescannten Dokumenten. Die OCR-Verarbeitung dauert länger als die Textextraktion aus digitalen PDFs und die Geschwindigkeit hängt von Ihrer Hardware ab.
Ausblick: OCR für gescannte Dokumente
Die OCR-Technologie schreitet rapide voran. Große Sprachmodelle werden zur Dokumentation von Verständnisaufgaben verwendet, sodass OCR-Engines kontextuelle Überlegungen verwenden können -- erkennend, dass eine Ziffer in einer Spalte "Amount" wahrscheinlicher ist 5 als S, oder dass ein Datumsfeld einem bestimmten Format folgen sollte. Multimodale Modelle, die sowohl visuelle als auch textuelle Informationen gleichzeitig verarbeiten, zeigen vielversprechende Ergebnisse in akademischen Benchmarks, und diese Fortschritte werden wahrscheinlich in den nächsten Jahren zu Produktions-OCR-Tools führen.
Für Buchhaltungsfachkräfte besteht die praktische Implikation darin, dass sich die OCR-Genauigkeit auf gescannten Kontoauszügen weiter verbessern wird und die Lücke zwischen Cloud und On-Device OCR verringert, sobald kleinere, effizientere Modelle verfügbar werden. Allerdings wird die Überprüfung für die absehbare Zukunft unerlässlich bleiben - Finanzdaten erfordern ein Maß an Präzision, das kein OCR-Motor ohne menschliche Überprüfung garantieren kann.
Fazit
Das Konvertieren gescannter Kontoauszüge in CSV erfordert OCR als Zwischenschritt, und dieser Schritt führt Genauigkeitsüberlegungen ein, die mit digital generierten PDFs nicht existieren. Die Qualität Ihrer Ergebnisse hängt von der Scanauflösung, dem Dokumentzustand und der von Ihnen gewählten OCR-Engine ab. Open-Source-Tools wie Tesseract bieten Flexibilität für Entwickler, Cloud-Services bieten höchste Genauigkeit bei anspruchsvollen Dokumenten und On-Device-Lösungen wie LocalExtract priorisieren die Privatsphäre, indem alle Verarbeitungen vor Ort bleiben. Egal, welcher Ansatz Sie verwenden, überprüfen Sie immer OCR-Ausgabe mit der ursprünglichen Kontoauszug, bevor Sie Daten in Ihre Buchhaltungssoftware importieren. Bessere Scan-Praktiken an der Quelle -- 300 DPI, flache Platzierung, Graustufen-Modus -- bleiben die effektivste Möglichkeit, Fehler stromabwärts zu reduzieren.
Häufige Fragen
Wie kann ich feststellen, ob mein PDF-Kontoauszug gescannt oder textbasiert ist? Öffnen Sie das PDF und versuchen Sie, Text mit Ihrem Cursor auszuwählen. Wenn Sie einzelne Wörter hervorheben und kopieren können, ist das PDF textbasiert. Wenn das Klicken und Ziehen nichts auswählt oder die gesamte Seite als Bild auswählt, wird das PDF gescannt und benötigt OCR.
Mit welcher DPI-Auflösung sollte ich Kontoauszüge für OCR scannen? Mindestens 300 DPI. Für Kontoauszüge mit kleinem Transaktionstext verbessert 400-600 DPI die Genauigkeit. Über 600 DPI erzeugt abnehmende Renditen.
Ist die OCR-Ausgabe genau genug, um ohne Überprüfung zu verwenden? Nein. Selbst die besten OCR-Motoren machen Fehler, und Finanzdaten haben Nulltoleranz für Charakter-Level-Fehler. Verifizieren Sie immer mit dem Original — mindestens, vergleichen Sie Transaktionszahlen und Spaltensummen.
Kann ich Kontoauszüge für OCR mit dem Smartphone scannen? Ja, aber nutzen Sie lieber eine dedizierte Scan-App (Microsoft Lens, Adobe Scan oder Apple Notes) als die Standardkamera. Diese Apps verwenden perspektivische Korrektur und Kontrastverbesserung automatisch. Telefon-Scans arbeiten für saubere Dokumente, sondern produzieren weniger Qualität als ein Flachbett-Scanner.
Was ist der Unterschied zwischen Tesseract und Cloud OCR-Diensten? Tesseract ist frei und läuft lokal aus, gibt aber Rohtext ohne Dokumentstruktur aus – Sie müssen ihn selbst in eine Tabelle einlesen. Cloud-Dienste (AWS Textract, Google Vision) bieten eine höhere Genauigkeit und strukturierte Tabellenextraktion, erfordern aber das Hochladen von Dokumenten auf Server von Drittanbietern und berechnen pro Seite Gebühren.
Benötigt LocalExtract eine Internetverbindung für OCR? Nein. LocalExtract läuft PP-OCRv5 durch ONNX Runtime komplett auf Ihrem Gerät. Das OCR-Modell wird mit der Anwendung gebündelt, so dass während der Verarbeitung keine Internetverbindung benötigt wird.
Wie viel kostet LocalExtract? Kostenloser Tarif: insgesamt 10 Seiten. Pro-Plan: $10/Monat oder $60/Jahr, ohne Seitenlimits; Verarbeiten Sie jeweils ein PDF. Beide Ebenen verarbeiten Dateien vollständig auf Ihrem Gerät.
Kann OCR Kontoauszüge in anderen Sprachen als Englisch bearbeiten? PP-OCRv5 unterstützt mehrere Sprachen zur Zeichenerkennung. Allerdings konzentriert sich LocalExtracts Kontoauszug Analyse Logik derzeit auf englischsprachige US-Kontoauszüge. Die OCR-Engine kann Zeichen in anderen Sprachen erkennen, aber strukturierte Extraktion funktioniert möglicherweise nicht korrekt für nicht-US-Formate.
Transparenzhinweis: Dieser Artikel stammt vom LocalExtract-Team. Wir entwickeln den Desktop-Konverter und haben ein wirtschaftliches Interesse an diesem Thema. Vergleichen Sie die exportierten Zeilen mit Ihrem eigenen Kontoauszug. Bankanleitungen und allgemeine Screenshots sind keine Kompatibilitätsgarantien.
Tesseract liest Bilddateien, keine PDF-Eingaben. Wandeln Sie eine Seite zunächst in PNG um oder verwenden Sie OCRmyPDF für PDF-Dateien. Siehe die offizielle Dokumentation zu Eingabeformaten, geprüft am 11. Oktober 2026.
LocalExtract Team
Wir entwickeln LocalExtract, einen Kontoauszug-Konverter für den Desktop. Fragen oder Korrekturen? Kontakt · Redaktionsrichtlinien