
Extraire les données d’un relevé bancaire PDF
Mis à jour · 20 min de lecture
Points clés
- états de compte bancaires PDF ne contiennent pas de tableaux — ils contiennent des éléments de texte positionnés qui ressemblent visuellement à des tableaux. L'extraction de données structurées nécessite la reconstruction des lignes et des colonnes à partir des coordonnées.
- Les bibliothèques Python Open-source comme Tabula, pdfplumber et Camelot peuvent extraire les données de transaction de manière programmatique, mais chaque fois gère les cas de bord différemment et nécessite un réglage par format bancaire.
- Les services d'extraction en nuage offrent une commodité, mais nécessitent l’envoi de données financières sensibles sur des serveurs tiers – une considération pour les professionnels liés par la règle de sauvegarde FTC.
- Les outils sur l'appareil traitent les PDF localement sans accès au réseau, en conservant les numéros de compte, les soldes et l'historique des transactions sur votre machine.
- Chaque méthode d'extraction nécessite une étape de vérification. La comparaison du total extrait avec le total imprimé de la relevé est le moyen le plus rapide pour attraper les transactions manquantes ou dupliquées.
Transparence : cet article est publié par l’équipe LocalExtract, qui développe le convertisseur de bureau et a un intérêt commercial dans ce sujet. Comparez les lignes exportées à votre propre relevé. Les guides bancaires et les captures d’écran générales ne garantissent pas la compatibilité.
L'extraction des données d'un relevé de compte bancaire PDF semble être simple. Les transactions sont juste là — dates, descriptions, montants, soldes — indiquées dans des lignes et des colonnes claires. Lisez la table.
Le problème, c'est qu'il n'y a pas de table. Un PDF est un format de description de page conçu pour l'impression, et non pour l'échange de données. Ce qui ressemble à une table à l'écran est en fait une collection de fragments de texte positionnés individuellement. Le fichier PDF dit "tirer la chaîne '03/07/2026' aux coordonnées (72, 540)" et "tirer '-150.00' aux coordonnées (480, 540)". Vos yeux voient une rangée. Le fichier voit un texte non lié.
Cet article couvre cinq méthodes d'extraction, depuis la copie manuelle-coller jusqu'aux bibliothèques Python open source jusqu'aux outils on-device, avec des exemples de code de travail et un workflow de vérification. Si vous avez juste besoin de convertir un relevé de compte bancaire PDF en CSV, ce guide couvre le chemin le plus rapide. Cet article va plus loin dans Pourquoi l'extraction est difficile et la façon dont chaque méthode gère les cas de bord.
Fonctionnalités de l’application de bureau LocalExtract : Exportez un PDF sélectionné à la fois en CSV avec les colonnes
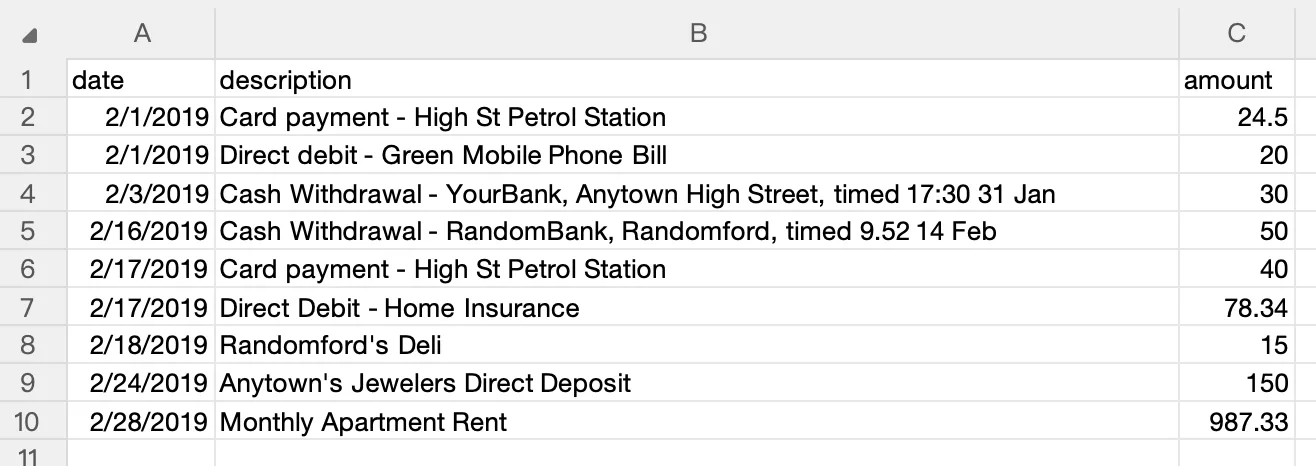
date,descriptionetamount. Ouvrez le fichier CSV dans Excel et enregistrez-le en XLSX si nécessaire. L’application ne propose ni file d’attente par lots, ni export JSON, QBO ou OFX, ni synchronisation comptable. L’analyse PDF et l’OCR s’exécutent localement. Les services de compte, d’abonnement et de mise à jour nécessitent Internet, y compris la vérification périodique de l’abonnement Pro. Testez votre propre relevé et vérifiez chaque ligne : une langue prise en charge ou un guide bancaire ne garantit pas la compatibilité avec tous les formats de relevés.
Les applications exportent la date, la description et le montant en CSV. Ouvrez ce CSV dans Excel pour enregistrer un classeur XLSX. Vérifiez le résultat avec votre PDF : la compatibilité dépend du format du relevé.
Pourquoi l’extraction de données PDF est difficile
Avant de choisir une méthode, elle aide à comprendre pourquoi ce problème existe. L'extraction de PDF n'est pas un problème résolu — c'est un ensemble d'heuristiques qui fonctionnent bien dans les cas courants et échouent dans les cas de bord.
Aucune structure de table dans le fichier. Un PDF ne stocke pas les métadonnées de table. Il n'y a pas d'objet "table", pas d'objet "row", pas d'objet "cell". Le fichier contient des instructions de dessin : placer cette chaîne de texte à ces coordonnées (x, y), tracer une ligne du point A au point B. Pour extraire une table, le logiciel doit inverser la mise en page en regroupant les éléments de texte qui partagent la même position verticale en lignes et en déterminant les limites des colonnes à partir de l'alignement horizontal.
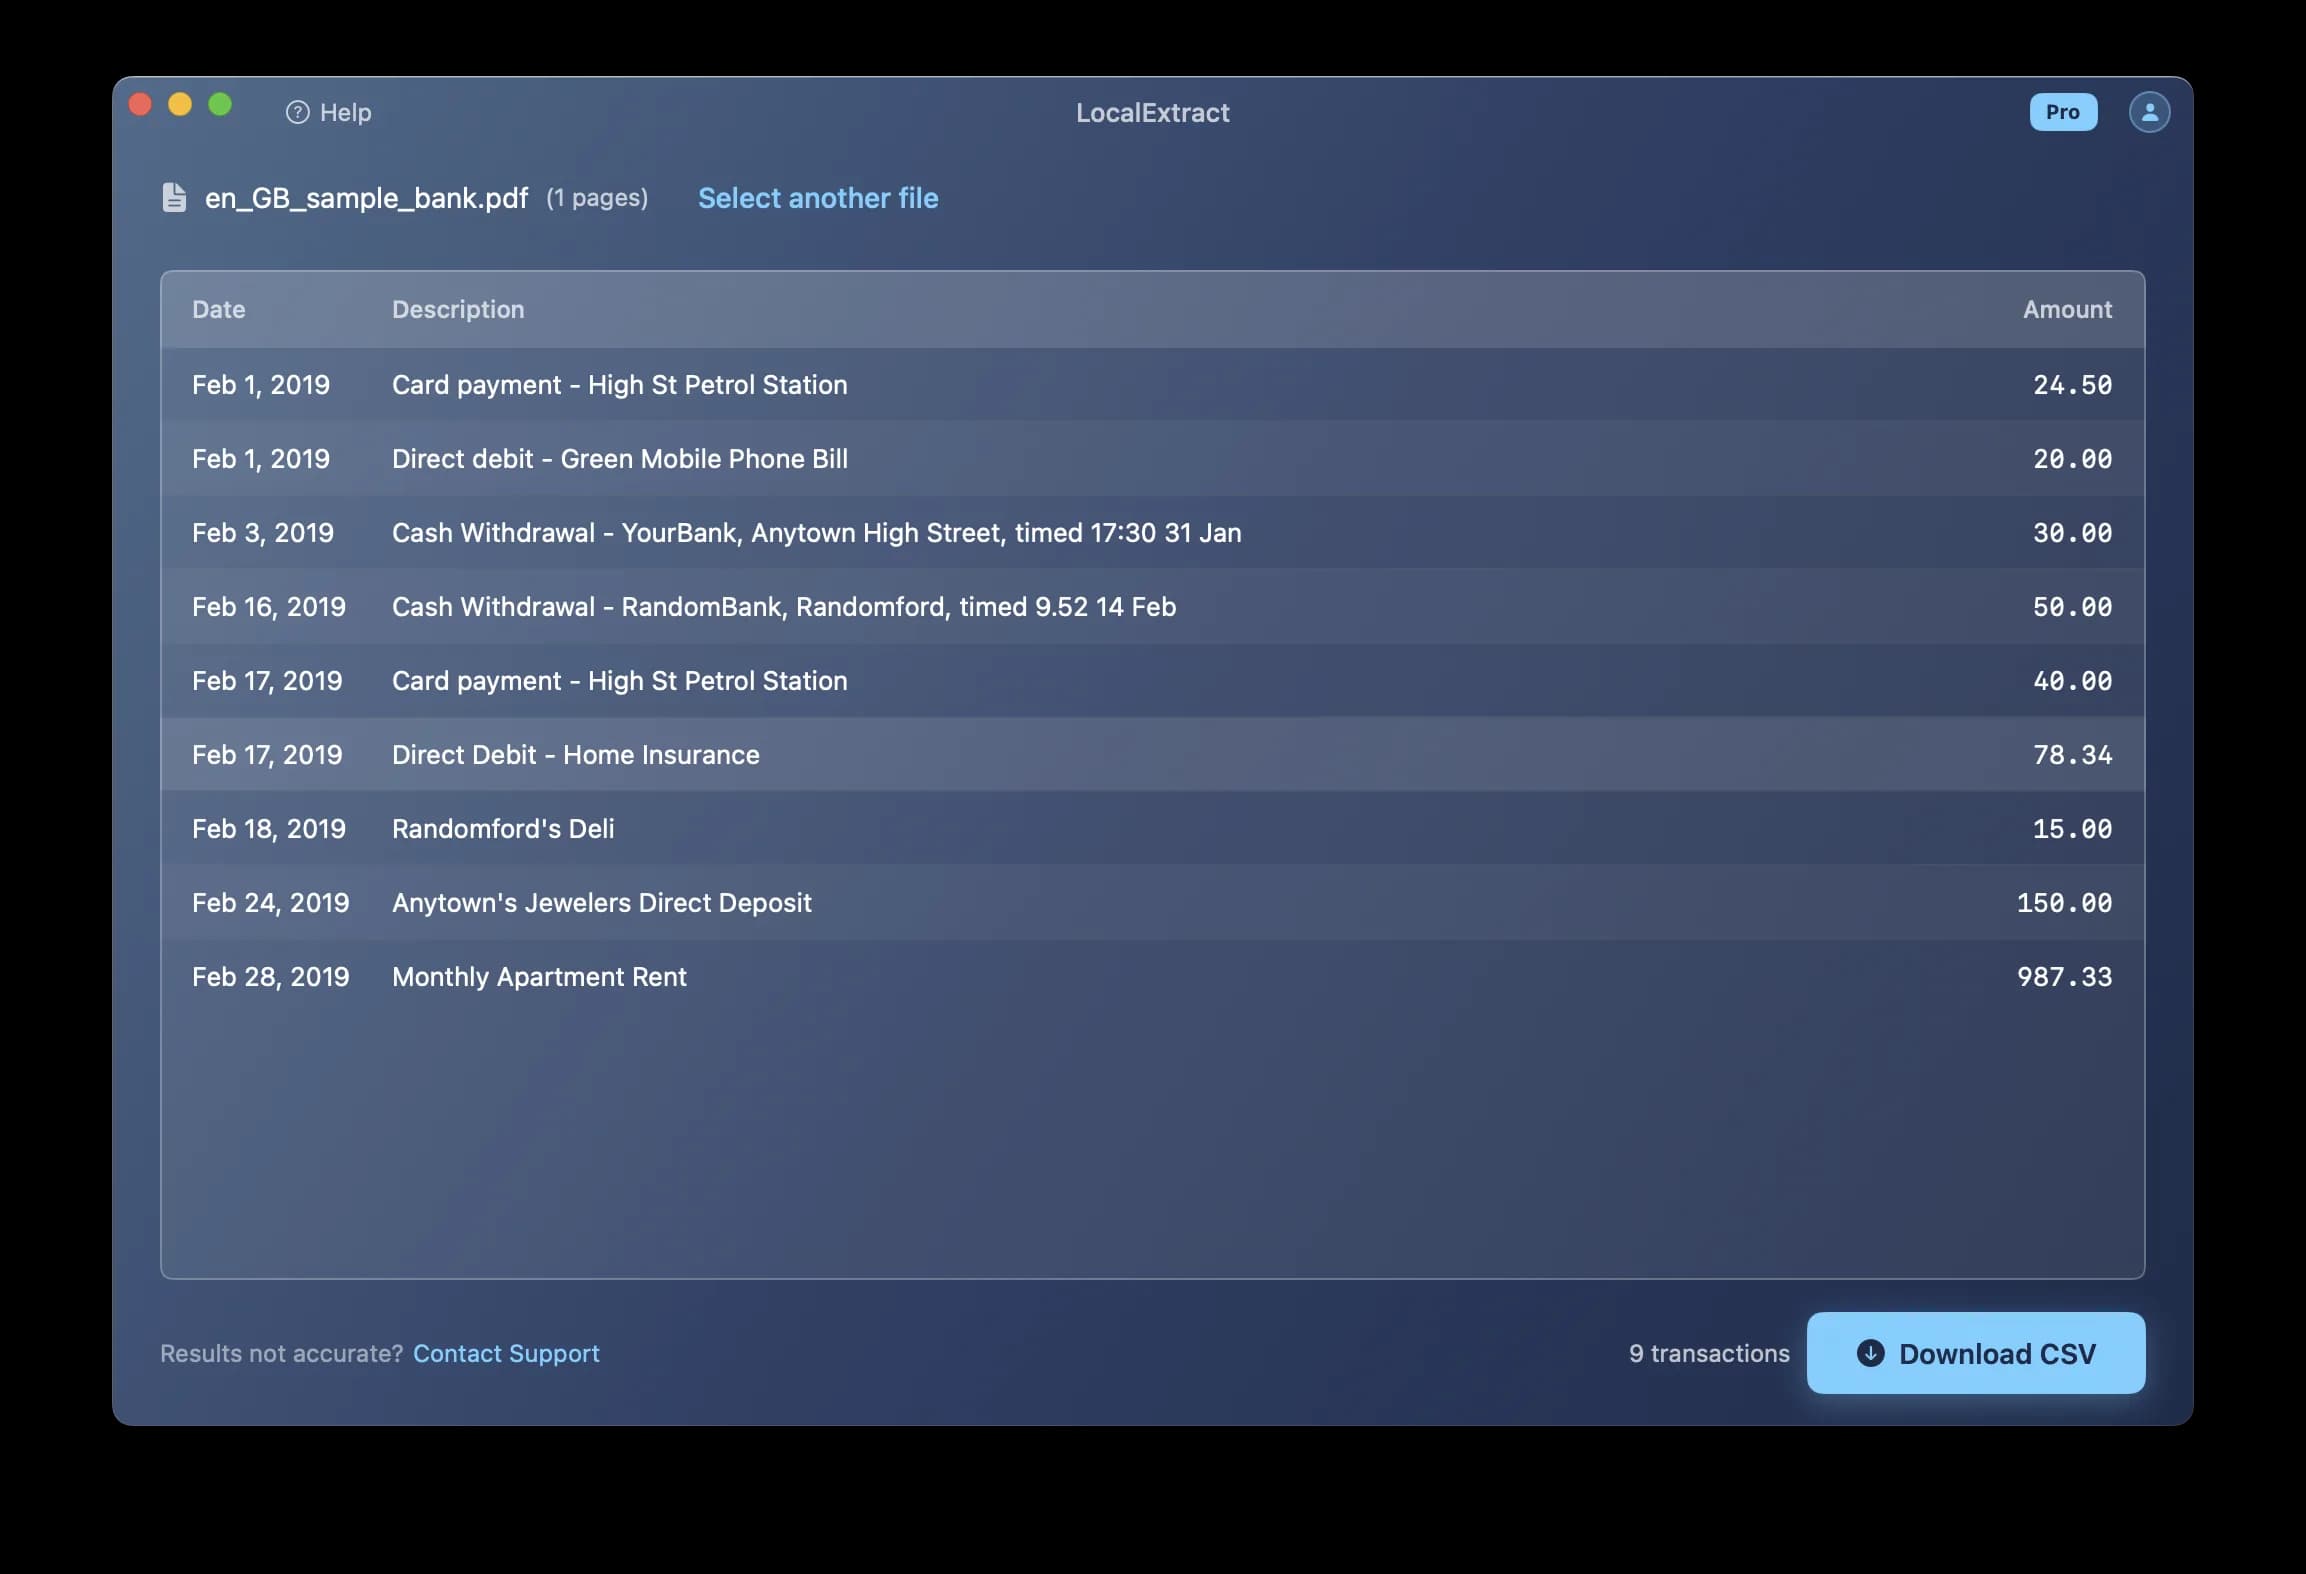
Les captures d’écran illustrent une méthode générale, pas des résultats d’extraction vérifiés pour une banque précise.
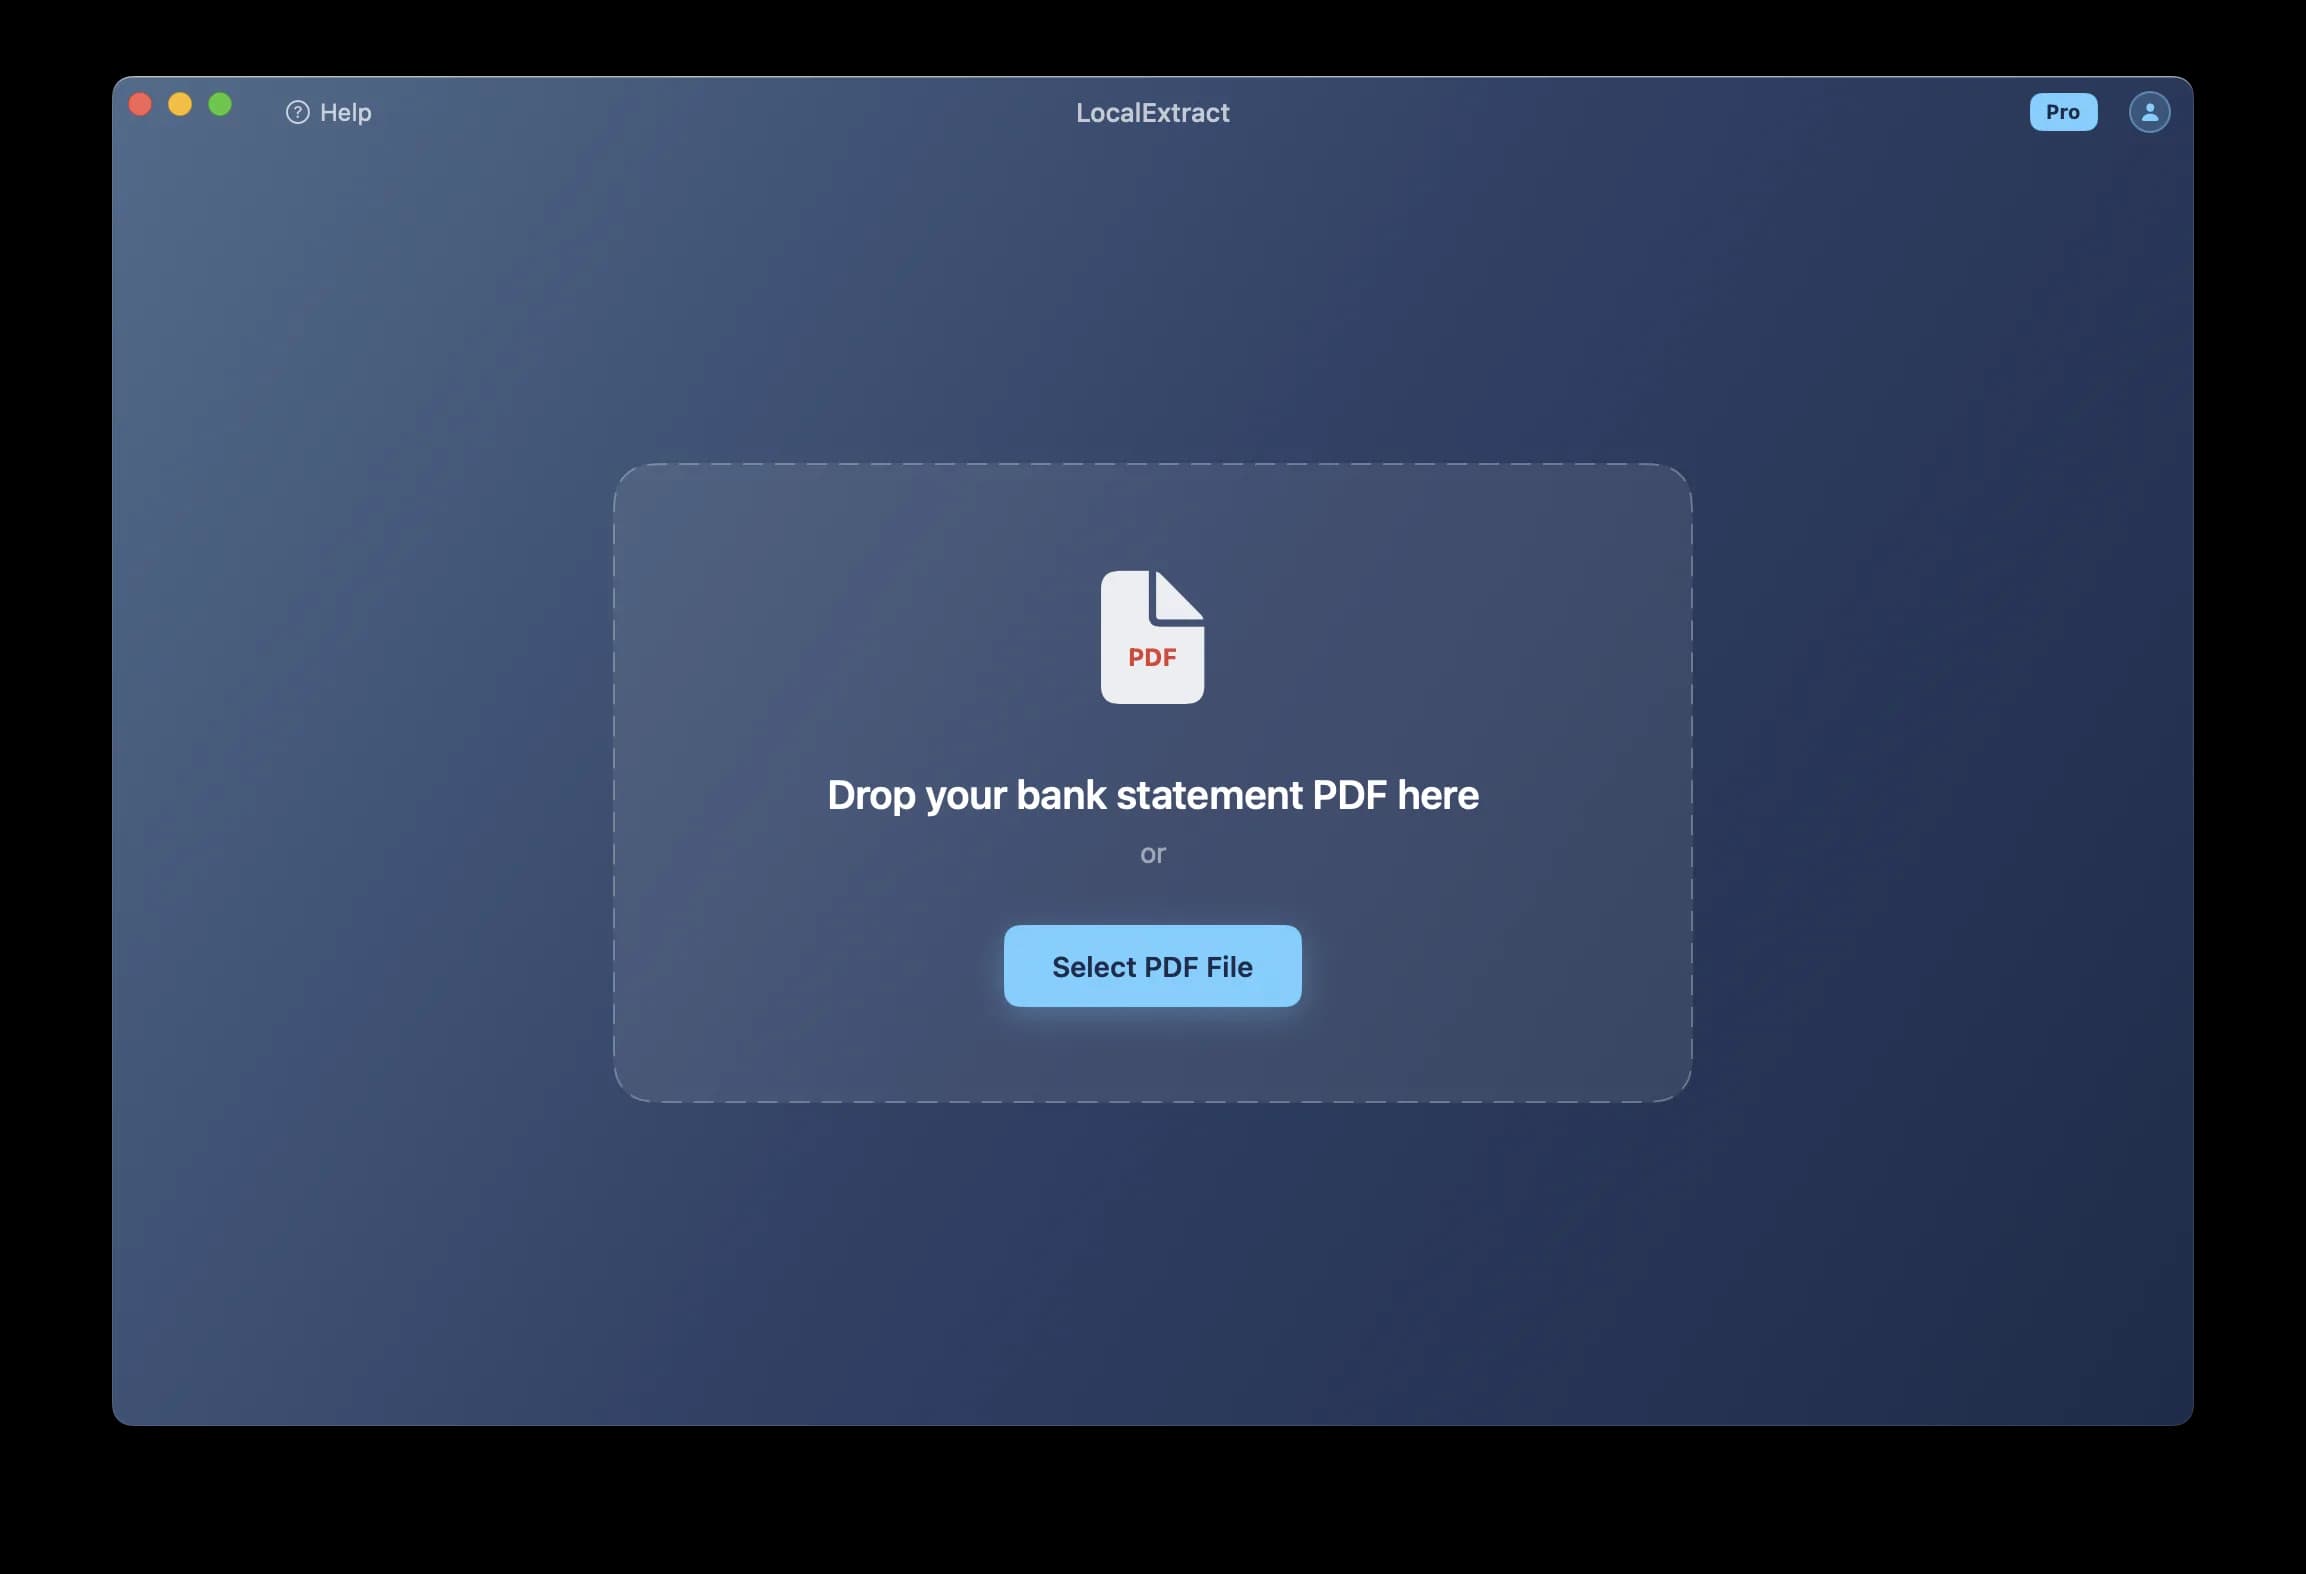
Tableaux multi-pages. les relevés de comptes bancaires couvrent régulièrement plusieurs pages. Le logiciel d'extraction doit reconnaître les continuations de table, sauter les en-têtes répétés, ignorer les pied de page, et les données de point ensemble. Une seule pause de page oubliée peut dupliquer les en-têtes comme lignes de données ou faire tomber des transactions.
Descriptions multilignes. Certaines banques répartissent les détails de la transaction entre deux lignes — la description sur une ligne, un numéro de contrôle ou un code de référence sur la suivante. Le logiciel d'extraction doit reconnaître que la deuxième ligne appartient à la première transaction, et non qu'il s'agit d'une transaction distincte avec des champs manquants.
PDF numérisés par rapport aux PDF numériques. Les PDF numériques contiennent des caractères textuels réels. Les PDF numérisés sont des images sans données textuelles, exigeant que l'OCR (Optical Character Recognition) soit une étape de prétraitement. Les moteurs modernes OCR atteignent une précision de niveau de caractère supérieure à 99 % sur des documents propres, mais même un taux d'erreur de 0,5 % peut corrompre des montants en dollars ou transposer des chiffres dans des numéros de compte. Pour un aperçu de la façon de traiter les relevés scannées, voir comment convertir un relevé de compte bancaire numérisé en CSV.
Méthode 1 : copier-coller manuel
Meilleur pour : Déclarations d'une page, tâches ponctuelles, relevés comportant moins de 20 transactions.
L'approche la plus simple : ouvrez le PDF, sélectionnez la table de transaction, copiez-la et collez-la dans un tableur.
Étapes :
- Ouvrez le PDF dans n'importe quel visualisateur (Preview, Adobe Acrobat, Chrome).
- Sélectionnez les lignes de transaction. Essayez de sélectionner simplement la table, pas les en-têtes, les pied de page ou les résumés de compte.
- Copier (Ctrl+C / Cmd+C).
- Coller dans un tableur (Excel, Google Sheets).
- Nettoyer : corriger l'alignement des colonnes, supprimer les lignes blanches, les dates de reformatage et les montants.
- Exporter comme CSV ou utiliser directement dans la feuille de calcul.
Limites: L'alignement des colonnes est souvent incorrect après le collage. Les montants peuvent être inscrits dans la colonne de description. Les descriptions multilignes peuvent se diviser entre les lignes. Pour les relevés multi-pages, vous répétez ce processus pour chaque page et combinez manuellement les résultats. Attendez 10-30 minutes par énoncé, avec un risque significatif d'erreurs de transcription sur chaque passage.
Méthode 2 : Bibliothèques de Python à source ouverte
Meilleur pour : Développeurs et utilisateurs techniquement enclins qui ont besoin de traiter les relevés bancaires de façon programmatique, veulent un contrôle total sur la logique d'extraction, ou doivent intégrer l'extraction dans un pipeline automatisé.
Plusieurs bibliothèques Python open-source peuvent extraire des données tabulaires à partir de PDF. Les trois plus utilisés sont Tabula, pdfplumber et Camelot. Chacun adopte une approche différente du problème.
Tabula (Tabula-py)
Tabula utilise un moteur d'extraction basé sur Java (enveloppé pour Python) qui détecte les tables en analysant l'arrangement spatial des éléments de texte. Il prend en charge deux modes : "lattice" (utilise des lignes/frontières visibles pour trouver des tableaux) et "stream" (utilise l'alignement du texte lorsqu'il n'y a pas de frontières).
import tabula

# Extract all tables from a bank statement
tables = tabula.read_pdf(
    "statement.pdf",
    pages="all",
    multiple_tables=True,
    stream=True  # Use stream mode for borderless tables
)

# The first table is usually the transaction table
transactions = tables[0]
transactions.to_csv("transactions.csv", index=False)
Tabula fonctionne bien lorsque le PDF a un espacement cohérent des colonnes et du texte propre. Il lutte avec les PDF où les colonnes sont rapprochées ou où les montants ont un formatage variable (certains avec des signes en dollars, d'autres sans).
pdfplumber
pdfplumber vous donne un accès bas niveau à la position, la taille et la police de chaque élément texte. Cela le rend plus flexible que Tabula — vous pouvez écrire une logique personnalisée pour gérer les cas de bord — mais cela signifie aussi plus de code.
import pdfplumber
import csv

with pdfplumber.open("statement.pdf") as pdf:
    all_rows = []
    for page in pdf.pages:
        # Extract table with custom settings
        table = page.extract_table({
            "vertical_strategy": "text",
            "horizontal_strategy": "text",
            "snap_y_tolerance": 5,
            "intersection_x_tolerance": 15
        })
        if table:
            all_rows.extend(table)

# Write to CSV
with open("transactions.csv", "w", newline="") as f:
    writer = csv.writer(f)
    writer.writerow(["Date", "Description", "Amount", "Balance"])
    for row in all_rows:
        if row[0] and row[0].strip():  # Skip empty rows
            writer.writerow(row)
La force de pdfplumber est configurable. Les snap_y_tolerance et intersection_x_tolerance paramètres vous permettent d'accorder à quel point la bibliothèque groupe le texte en lignes et colonnes. Le compromis est que les paramètres optimaux diffèrent selon les banques — une relevé Chase peut nécessiter des tolérances différentes de celles d'une relevé Wells Fargo.
Camelot
Camelot est spécialement conçu pour l'extraction de table (pas l'extraction générale de texte PDF). Comme Tabula, il prend en charge les modes réseau et flux, mais il fournit également un score de précision pour chaque table détectée, ce qui vous aide à évaluer la qualité d'extraction programmatiquement.
import camelot

# Extract tables using stream mode (for borderless tables)
tables = camelot.read_pdf(
    "statement.pdf",
    flavor="stream",
    pages="all",
    edge_tol=50,
    row_tol=10
)

# Check accuracy for each table
for i, table in enumerate(tables):
    print(f"Table {i}: {table.parsing_report['accuracy']}% accuracy")

# Export the best table
if len(tables) > 0:
    tables[0].to_csv("transactions.csv")
Considérations pratiques pour les bibliothèques de Python
Ces bibliothèques fonctionnent bien pour les extractions ponctuelles, mais l'utilisation de la production implique des travaux continus : réglage par banque (chaque relevé de format de banque différemment), coutures multi-pages (traitement des en-têtes répétés et des pauses de page), post-traitement (collage des signes en dollars, conversion (150.00) à -150.00, les dates d'analyse), et la maintenance lorsque les banques redessinent leur présentation des états financiers.
Méthode 3 : Services d'extraction en nuage
Meilleur pour : Les utilisateurs qui veulent une grande précision sans écrire de code et sont à l'aise de envoyer des documents financiers sur un serveur tiers.
Les services basés sur le cloud utilisent le traitement côté serveur — combinant souvent l'analyse PDF avec des modèles d'apprentissage automatique — pour extraire des données structurées des relevés de comptes bancaires. Vous téléchargez le PDF, le service le traite et vous téléchargez les résultats sous forme de CSV, Excel ou JSON.
Exemples : Amazon Textract, Google Document AI, Azure Form Recognizer et des services spécialisés dans les documents financiers.
Ces services offrent une grande précision (surtout pour les formats bancaires américains communs), traitent à la fois les PDF numériques et numérisés, et ne nécessitent aucun code. Le compromis est que vous devez envoyer le relevé de compte bancaire — y compris les numéros de compte, les soldes et l'historique des transactions — sur un serveur distant. Les services basés sur l'API facturent également par page ou par document, et vous dépendez des politiques de prix et de conservation des données du fournisseur.
Méthode 4 : outils de tableur sur ordinateur
Meilleur pour : Les utilisateurs travaillant déjà dans Excel ou Google Sheets qui ont besoin d'une extraction rapide sans installer de logiciel supplémentaire.
Microsoft Excel et Google Sheets offrent des capacités d'importation PDF limitées.
Dans Excel, allez à Données > Obtenir des données > À partir du fichier > À partir du PDFC'est vrai. Excel détecte les tables et vous permet de les charger via Power Query. Cela fonctionne pour des tables simples et d'une seule page avec des bordures claires, mais échoue souvent avec des tables multi-pages et des mises en page sans frontières typiques des relevés de comptes bancaires.
Google Sheets n'importe pas nativement les PDF, mais vous pouvez envoyer le PDF sur Google Drive et choisir Ouvrir avec > Google Docs pour faire fonctionner OCR. La structure de la table est habituellement perdue en conversion, nécessitant un nettoyage manuel dans les feuilles.
Méthode 5 : outils d’extraction avec traitement local
Meilleur pour : Les professionnels qui ont besoin d'une extraction précise à partir de divers formats bancaires sans envoyer de données financières sensibles, et qui veulent un outil prêt à l'emploi sans écrire ou maintenir de code.
Les outils d'extraction sur l'appareil sont des applications de bureau qui traitent les PDF localement. Le fichier ne quitte jamais votre machine, aucune connexion Internet n'est requise, et aucun tiers n'a accès au contenu du document. Ces outils combinent l'extraction de texte PDF, l'analyse de la mise en page, l'OCR et la logique propre au format bancaire en une seule application – le réglage par banque et le post-traitement que les bibliothèques Python laissent à l'utilisateur sont intégrés.
LocalExtract est l'un de ces outils. Il fonctionne sur macOS et Windows, utilise un moteur basé sur Rust avec PDFium pour l'extraction de texte et PP-OCRv5 pour les documents numérisés, et exporte CSV à partir de l'interface de bureau. Le offre gratuite limitée comprend 10 pages (vie). Le plan Pro (10$/mois ou 60$/année) supprime les limites de pages.
D'autres outils sur l'appareil comprennent MoneyThumb (spécialisé dans la sortie QBO) et divers convertisseurs PDF-à-Excel de bureau.
Comparaison des cinq méthodes
Les cotes ci-dessous sont basées sur les tests de notre équipe sur 12 formats de relevés bancaires américains (Chase, Bank of America, Wells Fargo, Citi, US Bank, Capital One, PNC, TD Bank, Truist, Regions, Huntington et Cinquième Troisième) en utilisant des relevés mensuels allant de 2 à 15 pages. "Temps par état" mesure l'heure de l'horloge du mur de l'entrée au CSV utilisable, y compris tout nettoyage manuel. L'«exactitude» reflète l'exactitude au niveau de la transaction vérifiée par rapprochement total avec les totaux imprimés de l'énoncé.
| Méthode | Heure de configuration | Temps de relevé | Précision | Poignées PDF numérisées | Vie privée |
|---|---|---|---|---|---|
| Copie manuelle-coller | Aucune | 10-30 min | Dépend des précautions prises | Non | Complète (locale) |
| Bibliothèques Python | 1 à 4 heures | Deuxièmes (après réglage) | Haut pour les formats à l'écoute | Non (nécessite un OCR distinct) | Complète (locale) |
| Services en nuage | Procès-verbal | Secondes | Élevé pour les formats communs | Oui | Données téléchargées vers un tiers |
| Outils de feuille de calcul | Aucune | 5-15 min | Moyenne faible | Partiellement (Google Drive OCR) | Varie par plate-forme |
| Outils sur l'appareil | Procès-verbal | Secondes | Haut pour les formats pris en charge | Oui (si l'outil comprend le OCR) | Complète (locale) |
Vous ne savez pas quelle catégorie correspond à votre workflow? Notre aperçu de ce qu'est un convertisseur de relevé de compte bancaire explique le paysage plus en détail.
Comment vérifier les données extraites
Vérifiez toujours les données extraites avant de les utiliser pour la comptabilité ou la déclaration. Les erreurs d'extraction peuvent se propager à travers votre système de comptabilité.
Étape 1: Vérification du nombre de lignes
Comptez les transactions dans vos données extraites et comparez-les au PDF original. Si le PDF affiche 47 transactions et que votre CSV a 45 lignes, deux ont été abandonnées.
Étape 2 : rapprochement des totaux
Résumez les montants dans vos données extraites et comparez-les aux totaux imprimés de l'état (dépôts totaux, retraits totaux ou solde de clôture). Un total correspondant signifie que l'extraction a saisi chaque transaction correctement.
import csv
from decimal import Decimal

with open("transactions.csv") as f:
    reader = csv.DictReader(f)
    total = sum(Decimal(row["Amount"]) for row in reader)

print(f"Extracted total: {total}")
# Compare this against the statement's printed net change
Étape 3 : contrôler les cas particuliers par sondage
Vérifier manuellement quelques transactions spécifiques :
- Les premières et dernières transactions sur chaque page (les limites des pages sont le cluster des erreurs d'extraction).
- Toute transaction avec une description exceptionnellement longue (les descriptions multilignes sont sujettes au fractionnement ou à la troncation).
- La transaction la plus importante par montant (si les grands nombres sont bons, les petits sont généralement aussi).
Considérations relatives à la protection de la confidentialité et à la conformité
les états de compte bancaires contiennent des données financières sensibles : numéros de compte, numéros d'acheminement, historique des transactions, soldes et modèles de dépenses. La façon dont vous traitez ces données pendant l'extraction est importante, tant sur le plan éthique que juridique.
Les FTC Safeguards Rule exige que les institutions financières et certains prestataires de services professionnels, y compris les préparateurs d'impôts, les comptables et les comptables, mettent en oeuvre des mesures de protection pour l'information financière des clients. Les California Consumer Privacy Act (CCPA) ajoute des exigences supplémentaires pour les entreprises opérant en Californie.
Traitement local (copie-coller, bibliothèques Python, outils on-device) conserve les données sur votre machine. Traitement en nuage transmet les documents à un serveur distant — examine la politique de confidentialité du service et la période de conservation des données avant l’envoi. Pour les professionnels qui traitent les données financières des clients en vertu d'obligations réglementaires, les méthodes de traitement local éliminent toute une catégorie de questions de conformité.
LocalExtract: Capacités et limitations
LocalExtract est l'outil que notre équipe construit, et nous voulons être transparents sur ce qu'il fait bien et où il tombe à court.
Ce qu'il fait bien: Traiter les fichiers PDF numériques et numérisés (PP-OCRv5 intégré), gérer automatiquement les tables multipages, exporter trois colonnes CSV pour utilisation dans Excel, traiter les documents sur l'appareil sur macOS et Windows; les services de compte, d'abonnement et de mise à jour utilisent Internet.
Limites:
- La couverture bancaire n'est pas universelle. Fonctionne mieux avec les formats bancaires américains. Les banques non américaines ou les portails bancaires d'entreprise hautement personnalisés peuvent produire des résultats incomplets.
- Pas de sortie QBO ou IIF. Si votre workflow nécessite un format QBO, des outils comme MoneyThumb sont mieux adaptés.
- L'OCR dépend de la qualité du scan. Des scans à basse résolution, des pages biaisées ou des documents avec annotations manuscrites produisent des résultats de qualité inférieure.
- Le offre gratuite limitée est limité. Durée de vie de 10 pages — assez pour évaluer, mais Pro (10$/mois ou 60$/année) est nécessaire pour une utilisation régulière.
- Pas d'API par lots. Application bureautique seulement. Pour le traitement automatisé des pipelines, une solution basée sur Python ou l'API est plus appropriée.
Conclusion
Extraire des données d'un relevé de compte bancaire PDF est plus difficile qu'il ne semble parce que le format de fichier a été conçu pour l'impression, pas pour l'échange de données. La bonne méthode d'extraction dépend de votre volume, du confort technique et des exigences de confidentialité. Pour une tâche ponctuelle, copier-coller fonctionne. Pour les extractions récurrentes avec contrôle total, les bibliothèques Python vous offrent une flexibilité au prix d'un réglage par banque. Pour une précision pratique sans envoi de données sensibles, les outils on-device s'occupent des cas de bord -- tables multipages, documents numérisés, formatage propre à la banque -- de sorte que vous n'avez pas à le faire. Quelle que soit la méthode que vous choisissez, vérifiez toujours : comparez vos totaux extraits avec les totaux imprimés de l'état avant que les données entrent dans votre système comptable.
Questions fréquentes
Quelle est la façon la plus simple d'extraire les données d'un relevé de compte bancaire PDF? Pour une seule relevé, copier-coller manuellement dans un tableur est la méthode la plus simple — pas d'outils à installer, pas de comptes à créer. Pour tout ce qui dépasse une tâche ponctuelle, un outil d'extraction sur l'appareil permet d'économiser beaucoup de temps et réduit le risque d'erreurs manuelles. La bonne méthode dépend du nombre d'relevés que vous traitez et de leur fréquence.
Puis-je utiliser Python pour extraire les données du relevé de compte bancaire ? Oui. Des bibliothèques comme Tabula, pdfplumber et Camelot peuvent extraire des données tabulaires à partir de PDF numériques. Vous aurez besoin de code pour gérer le formatage spécifique à la banque, les tables multi-pages et le post-traitement. Les exemples de code dans cet article sont des points de départ fonctionnels.
Ai-je besoin de l'OCR pour extraire les données d'un relevé de compte bancaire PDF? Seulement si le PDF est scanné (une image de l'énoncé plutôt qu'un document numérique avec du texte sélectionnable). Vous pouvez tester ceci en essayant de sélectionner et copier du texte dans le PDF. Si le texte est sélectionnable, aucun OCR n'est nécessaire. Si le PDF se comporte comme une image, vous aurez besoin de OCR. Des outils comme Tesseract (open-source) ou les services commerciaux OCR peuvent convertir les PDF numérisés en texte avant l'extraction.
Quelle est la précision de l'extraction automatisée des données PDF? Pour les PDF numériques avec formatage propre, les outils d'extraction automatisés obtiennent généralement une très grande précision — souvent au-dessus de 99 % au niveau des transactions pour les formats bancaires pris en charge. Pour les PDF numérisés, la précision dépend de la qualité de l'analyse et du moteur OCR utilisé. Quelle que soit la méthode, vérifiez toujours les données extraites par rapport aux totaux imprimés de l'état avant de les utiliser à des fins comptables.
Est-il sûr de envoyer des relevés de compte bancaires vers un service d'extraction de cloud? Les services Cloud exigent la transmission de votre relevé de compte bancaire, y compris les numéros de compte, les soldes et les détails de transaction, à un serveur distant. La question de savoir si cela est acceptable dépend de vos exigences en matière de confidentialité, de vos obligations réglementaires et des politiques de traitement des données du service. Pour les professionnels liés par la règle de sauvegarde FTC, le chemin de conformité le plus simple est d'utiliser une méthode de traitement locale qui conserve les données sur votre propre machine.
Quels formats de sortie puis-je obtenir de l'extraction PDF? Les sorties les plus courantes sont CSV, Excel (XLSX) et JSON. CSV est le plus universel pour les importations de logiciels comptables -- voir notre guide relevé de compte bancaire format CSV pour la comptabilité pour les conventions de colonnes que QuickBooks, Xero et Wave attendent. Excel conserve le formatage et prend en charge plusieurs feuilles. JSON est utile pour le traitement des programmes. La plupart des outils d'extraction supportent au moins CSV.
Comment puis-je gérer les relevés de comptes bancaires avec plusieurs comptes sur le même PDF? Certaines banques combinent plusieurs comptes en un seul PDF. Les outils automatisés peuvent extraire toutes les transactions en une seule sortie, mélangeant les comptes. Après extraction, filtrez par numéro de compte ou par nom de compte pour les séparer.
Pourquoi mes données extraites ont-elles des lignes manquantes ou supplémentaires ? Les lignes manquantes résultent habituellement de ruptures de table ou de transactions dans un format inattendu. Les lignes supplémentaires proviennent généralement d'en-têtes répétés traités comme des lignes de données ou non-transaction (sous-totals, en-têtes de section) étant inclus. Vérifiez en comparant votre nombre de rangées et les totaux par rapport à l'énoncé original.
Transparence : cet article est publié par l’équipe LocalExtract, qui développe le convertisseur de bureau et a un intérêt commercial dans ce sujet. Comparez les lignes exportées à votre propre relevé. Les guides bancaires et les captures d’écran générales ne garantissent pas la compatibilité.
LocalExtract Team
Nous développons LocalExtract, un convertisseur de relevés pour ordinateur. Questions ou corrections ? Contact · Politique éditoriale