
Convertir un relevé bancaire scanné en CSV avec OCR
Mis à jour · 20 min de lecture
Points clés
- Les relevés de comptes bancaires numérisés sont des PDF basés sur l'image qui nécessitent la reconnaissance optique des caractères (OCR) avant que les données puissent être extraites — les analyseurs PDF standard ne peuvent les lire.
- La précision du OCR dépend de la qualité de l'analyse, de la résolution (300 DPI minimum) et de l'état des documents. Même les meilleurs moteurs OCR ne sont pas 100% précis, donc la vérification manuelle est essentielle.
- Trois approches OCR existent : open-source (Tesseratt), cloud (Google Vision, AWS Textratt) et on-device (LocalExtract utilise PP-OCRv5). Chacun implique des compromis différents en matière d'exactitude, de confidentialité et de coûts.
- Les relevés de compte scannés contiennent souvent des signatures, des notes manuscrites et des timbres — ces éléments comportent des risques supplémentaires en matière de confidentialité lorsqu'ils sont téléchargés sur les services en nuage.
- De meilleures pratiques de numérisation (haute DPI, placement à plat, originaux propres) améliorent directement la précision du OCR et réduisent le temps consacré aux corrections manuelles.
Transparence : cet article est publié par l’équipe LocalExtract, qui développe le convertisseur de bureau et a un intérêt commercial dans ce sujet. Comparez les lignes exportées à votre propre relevé. Les guides bancaires et les captures d’écran générales ne garantissent pas la compatibilité.
Les comptables et les comptables reçoivent régulièrement les relevés de comptes bancaires sous forme de PDF numérisés — pages photocopiées, captures de téléphones mobiles ou documents par télécopieur enregistrés sous forme de fichiers PDF. Contrairement aux PDF générés numériquement par les services bancaires en ligne, ces relevés numérisés sont des images enveloppées dans un conteneur PDF. Vous ne pouvez pas sélectionner le texte, copier les transactions ou utiliser un convertisseur PDF-à-CSV standard sans OCR.
Ce guide explique le fonctionnement de l’OCR, les facteurs de précision, les outils disponibles et la conversion des relevés scannés en CSV utilisables.
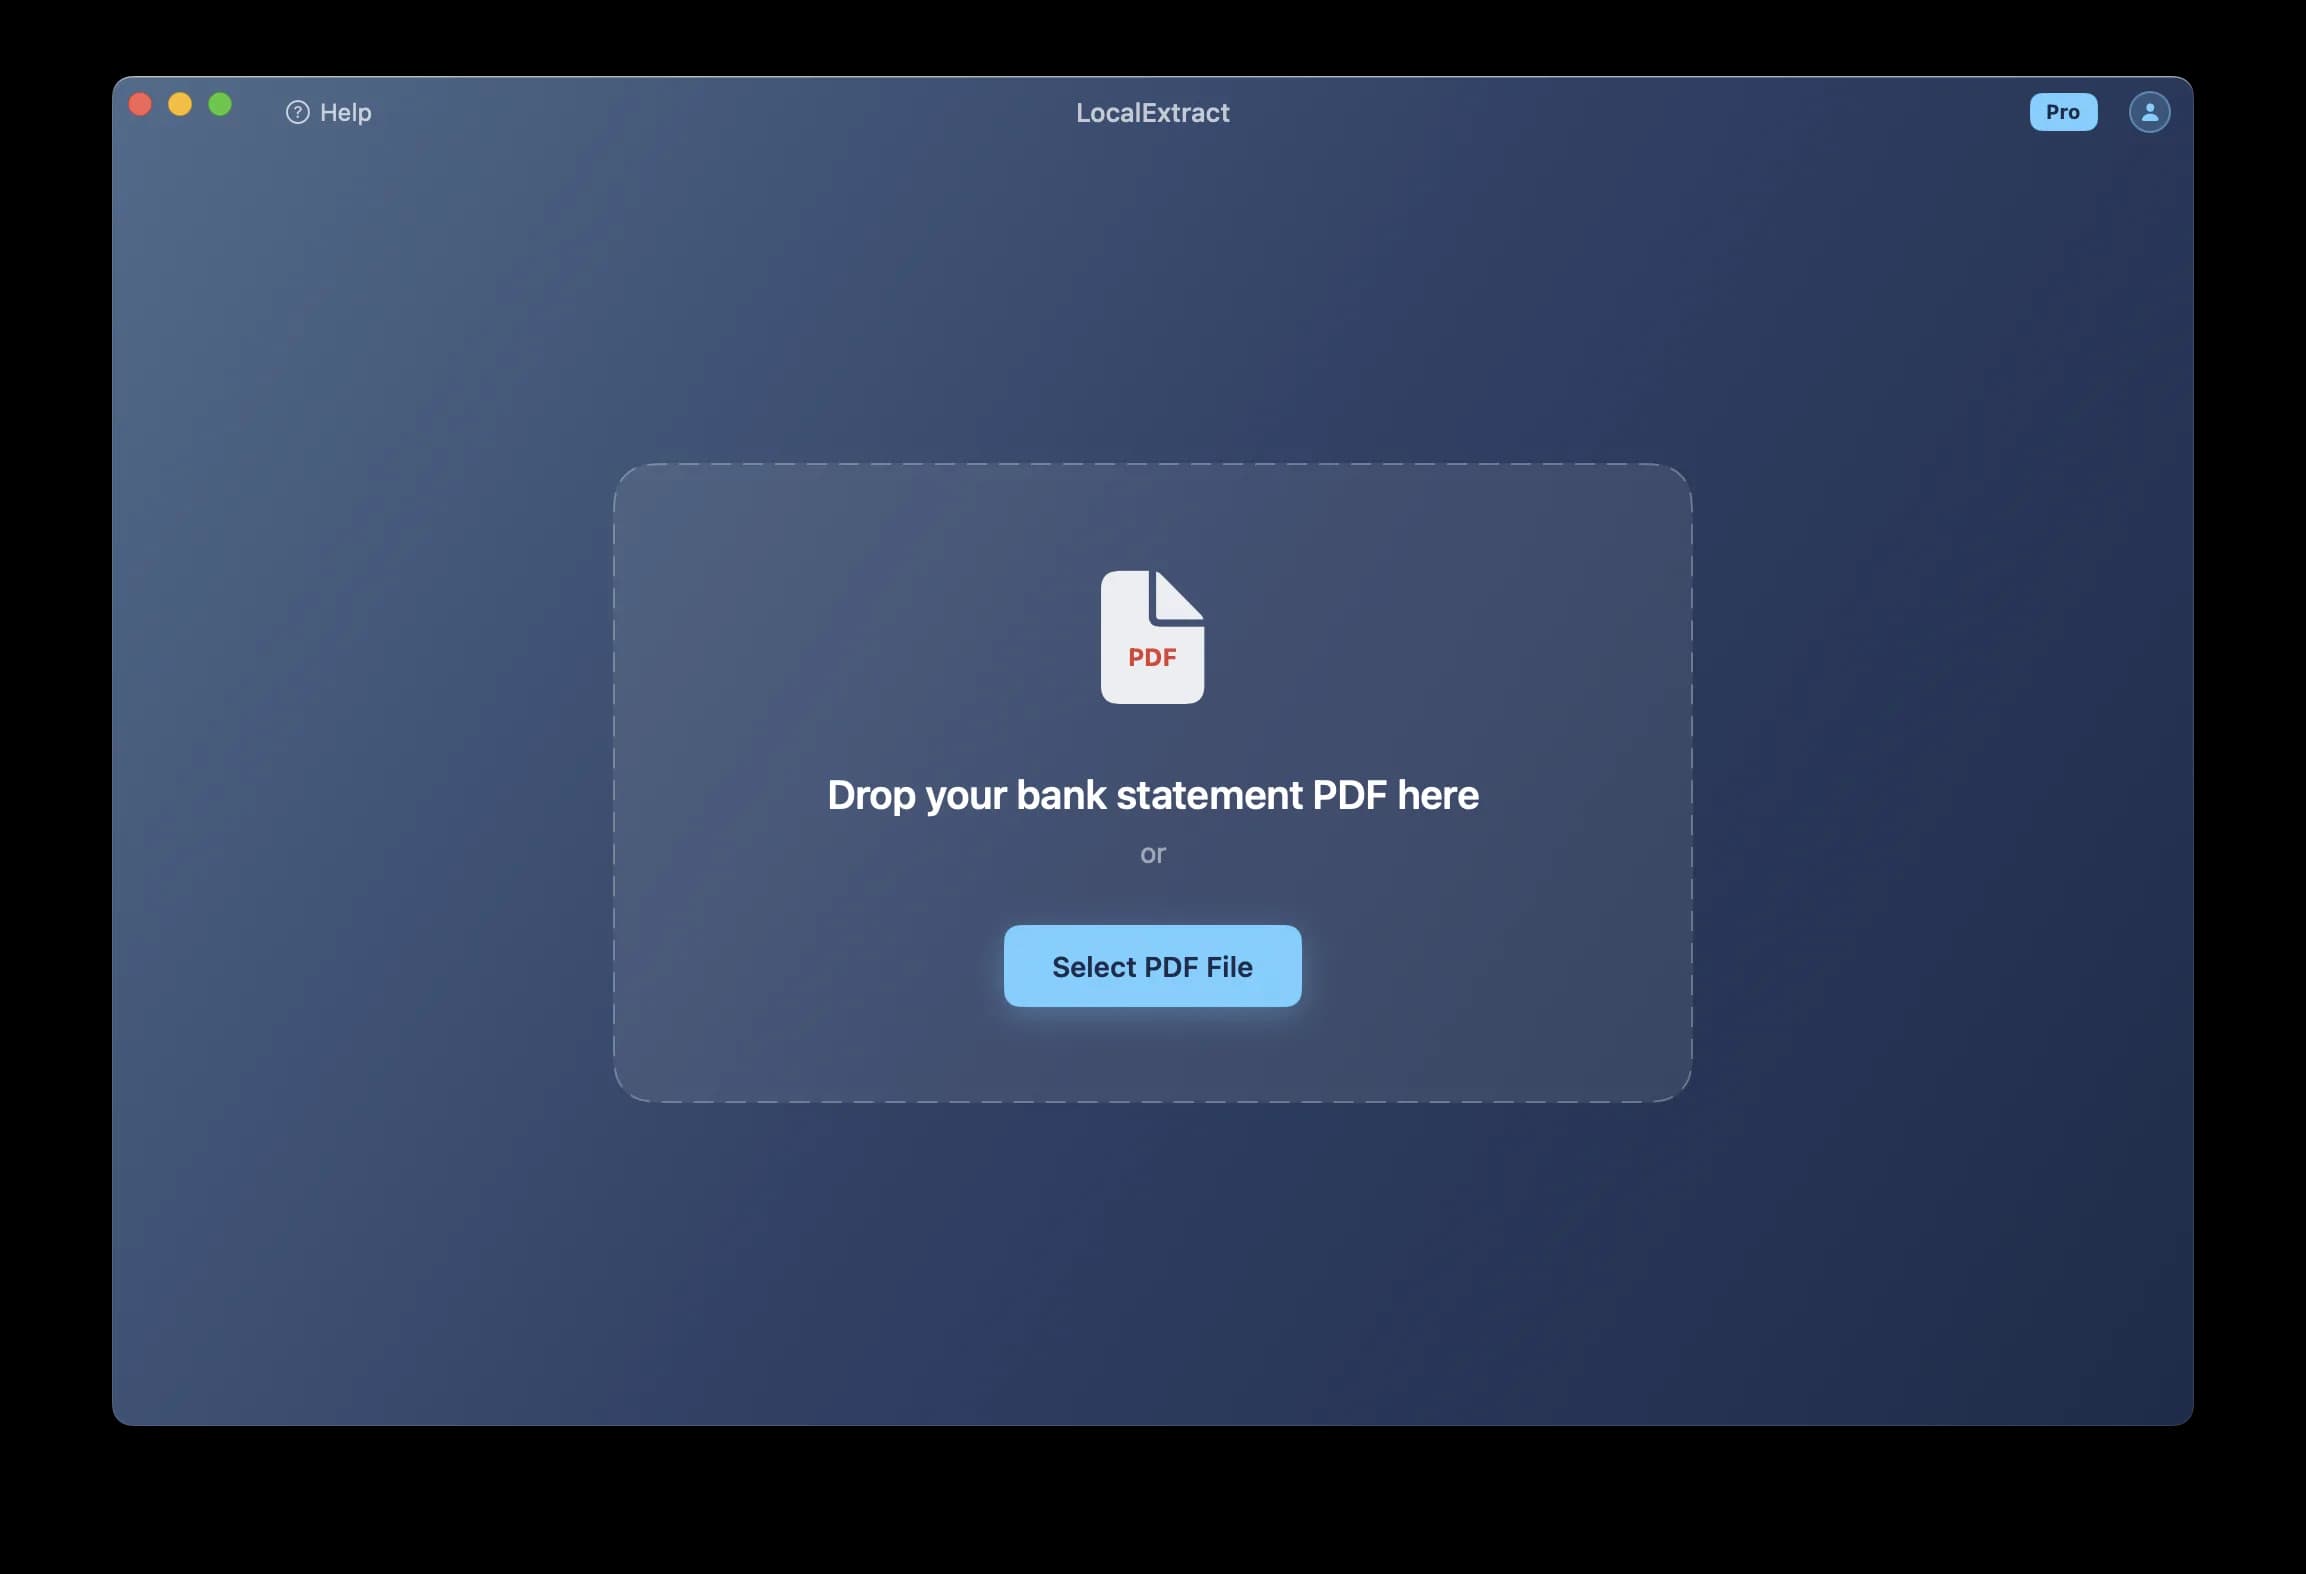
Fonctionnalités de l’application de bureau LocalExtract : Exportez un PDF sélectionné à la fois en CSV avec les colonnes
date,descriptionetamount. Ouvrez le fichier CSV dans Excel et enregistrez-le en XLSX si nécessaire. L’application ne propose ni file d’attente par lots, ni export JSON, QBO ou OFX, ni synchronisation comptable. L’analyse PDF et l’OCR s’exécutent localement. Les services de compte, d’abonnement et de mise à jour nécessitent Internet, y compris la vérification périodique de l’abonnement Pro. Testez votre propre relevé et vérifiez chaque ligne : une langue prise en charge ou un guide bancaire ne garantit pas la compatibilité avec tous les formats de relevés.
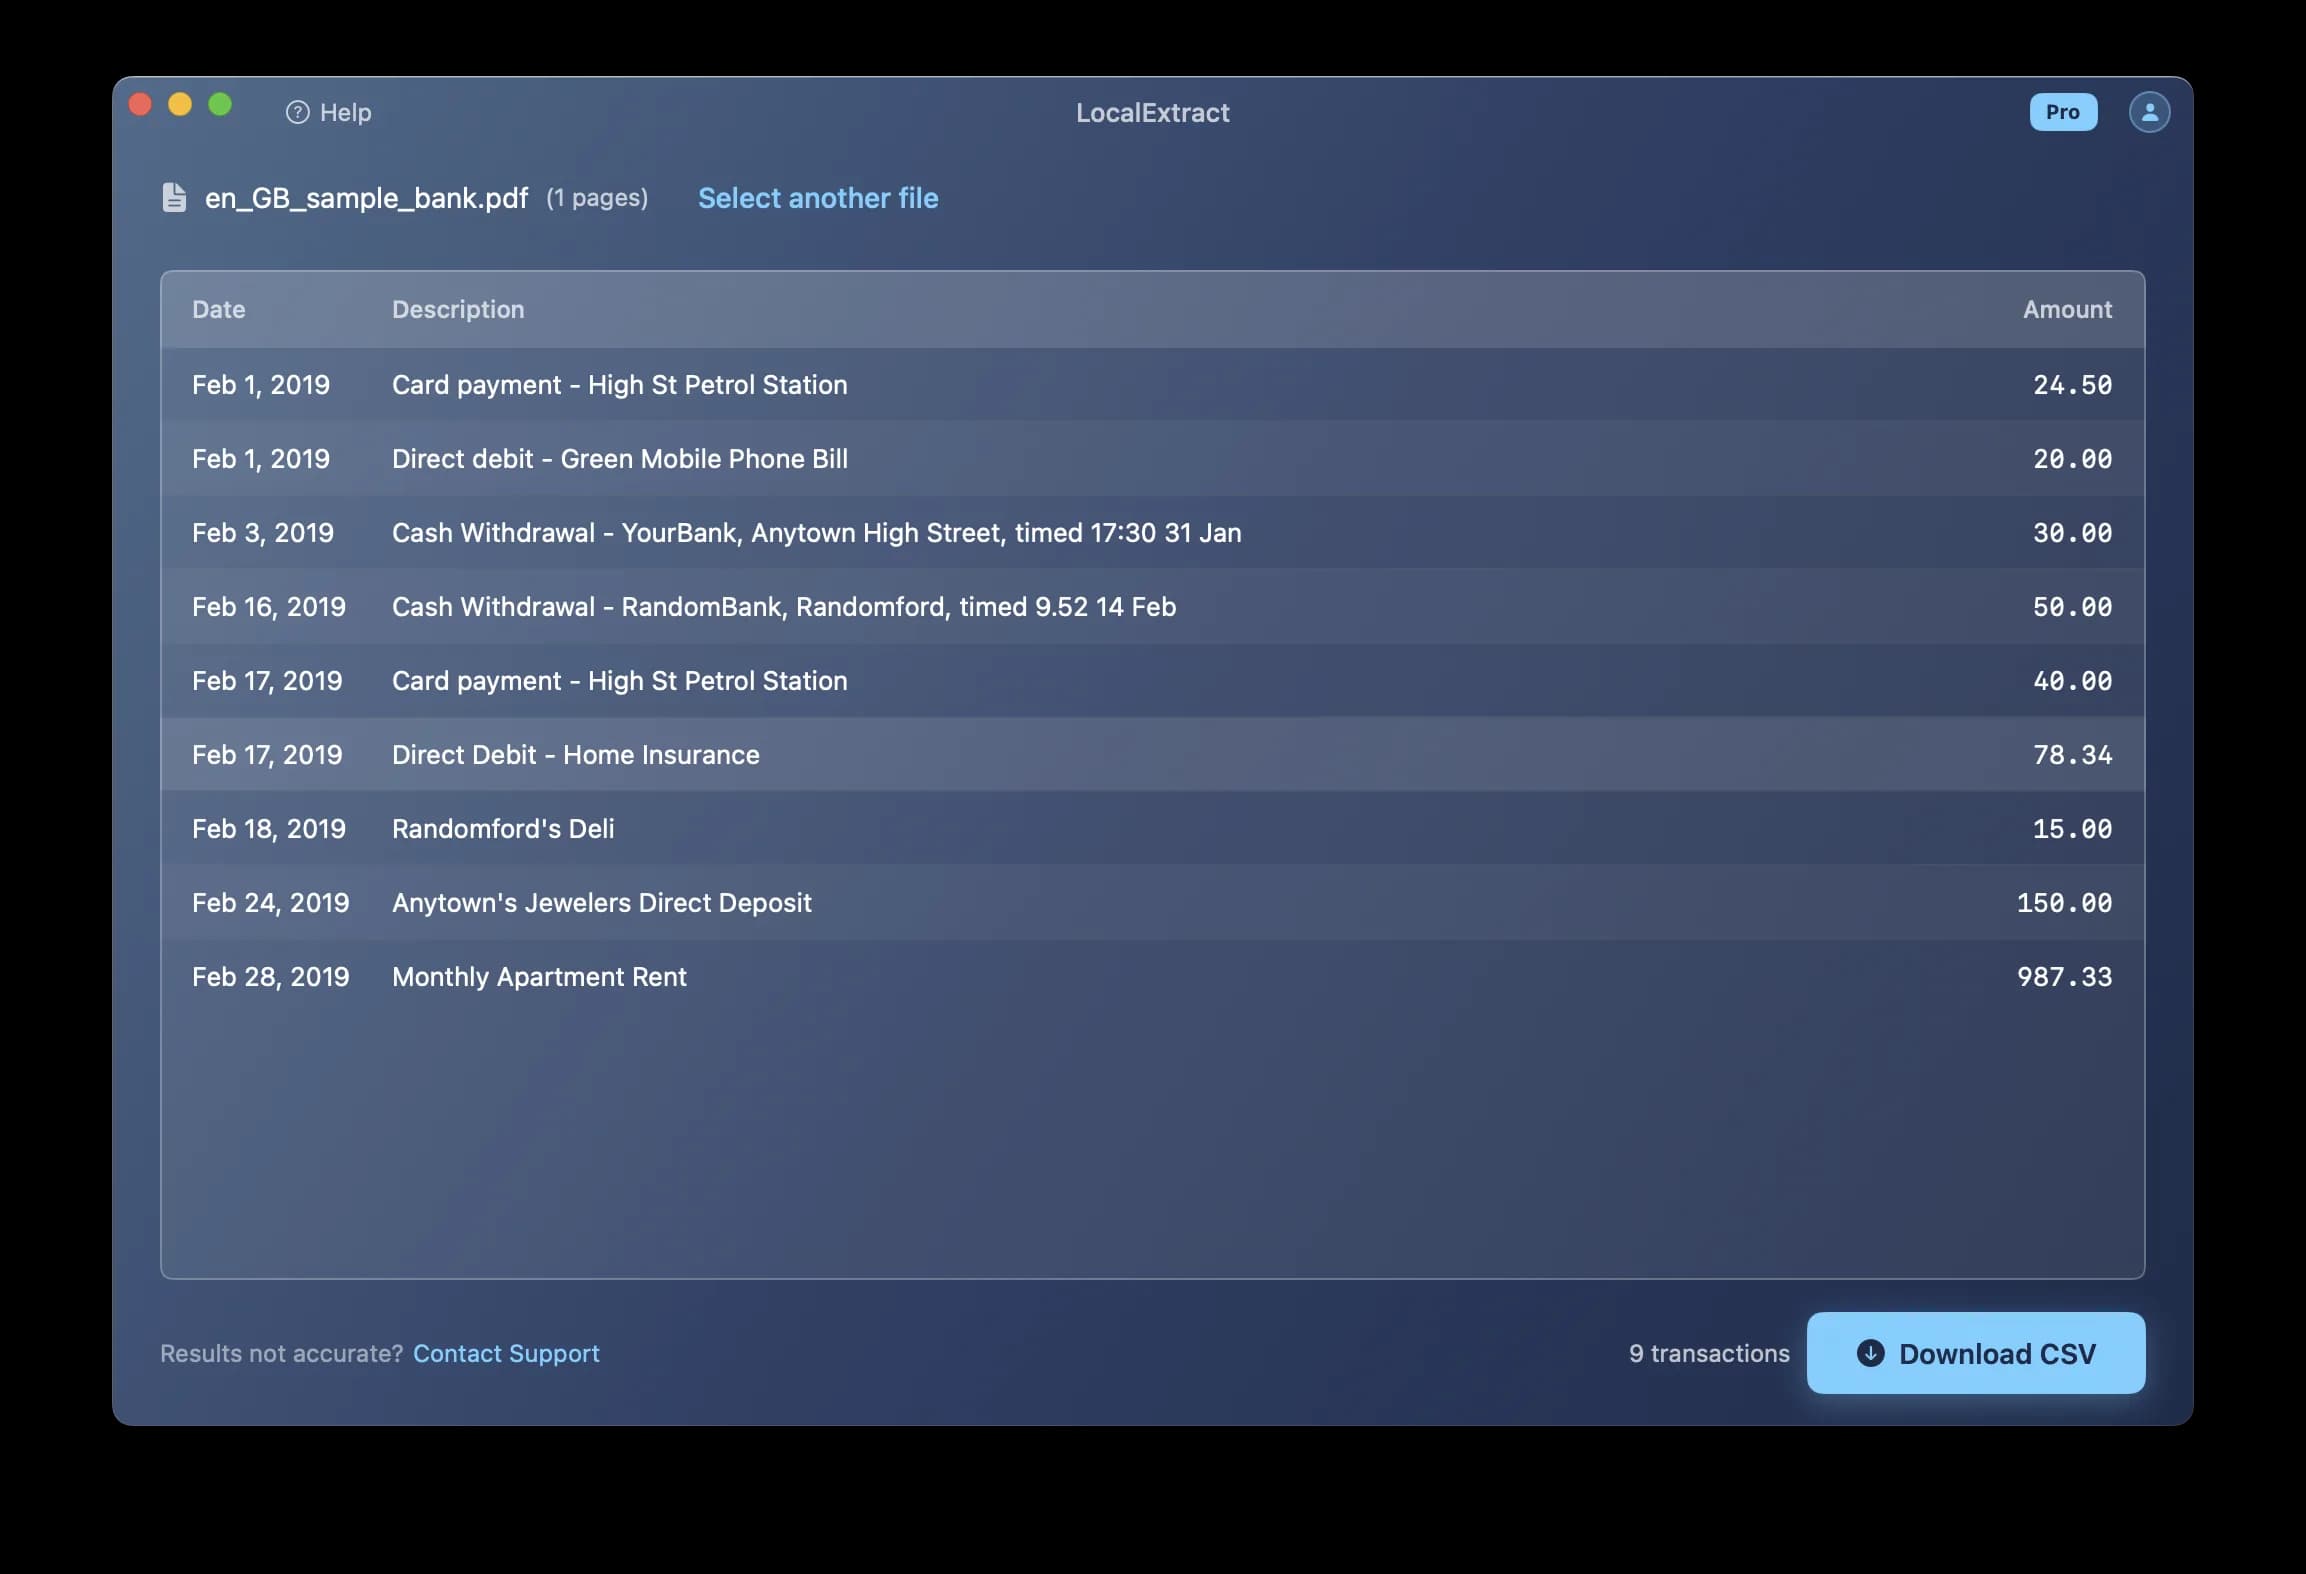
Les applications exportent la date, la description et le montant en CSV. Ouvrez ce CSV dans Excel pour enregistrer un classeur XLSX. Vérifiez le résultat avec votre PDF : la compatibilité dépend du format du relevé.
PDF par texte vs. PDF numérisé : Quelle est la différence?
La compréhension de cette distinction est essentielle parce qu'elle détermine quelle méthode de conversion fonctionnera.
PDF textuels sont générés numériquement. Lorsque le site Web de votre banque vous permet de télécharger une relevé, que PDF contient des données textuelles réelles — caractères, coordonnées et informations de police. Vous pouvez sélectionner le texte, rechercher les mots-clés et copier les transactions. Ces PDF se convertissent de façon fiable en CSV à l'aide d'outils d'extraction standard.
PDF scannés (images) contient des photographies de pages imprimées. Lorsque quelqu'un lance une relevé à travers un scanner, prend une photo du téléphone ou reçoit un fax, le PDF résultant stocke les données du pixel — une image de texte, pas de texte lui-même. Il n'y a pas de caractères à sélectionner et aucune donnée à copier.
Certains PDF se situent entre les deux. Un document scanné traité avec un logiciel OCR peut contenir une couche de texte invisible derrière l'image. Ces « PDF consultables » se comportent comme des PDF à base de texte pour l'extraction, bien que la couche de texte puisse contenir des erreurs de la passe OCR originale.
Les captures d’écran illustrent une méthode générale, pas des résultats d’extraction vérifiés pour une banque précise.
Pour un aperçu plus large de la conversion du papier et des relevés numériques en données structurées, voir notre guide sur Comment numériser les relevés de compte bancaires.
Qu'est-ce que l'OCR et comment fonctionne-t-il?
L'OCR représente Reconnaissance optique des caractèresC'est vrai. C'est la technologie qui convertit les images de texte en caractères lisibles par machine. Lorsqu'il est appliqué à un relevé de compte scanné, l'OCR analyse les patrons de pixel de l'image, identifie les formes qui correspondent aux lettres et aux nombres et affiche le texte reconnu.
Les systèmes modernes de OCR fonctionnent en plusieurs étapes : prétraitement de l'image (scannages serrés, suppression du bruit, réglage du contraste), détection de texte (identifier les régions contenant du texte et les séparer des logos, des bordures et de l'espace vide), reconnaissance des caractères (comparaison des caractères détectés avec les modèles d'apprentissage en profondeur formés), et après traitement (raffiner les résultats en utilisant des modèles de langage et des règles contextuelles — par exemple, corriger O à 0 dans une colonne numérique).
La sortie est un texte structuré qui peut ensuite être analysé dans des champs (date, description, montant) et écrit dans un fichier CSV. Pour une analyse détaillée de l'extraction de données structurées à partir de PDF numérisés et numériques, voir comment extraire les données du relevé de compte bancaire PDFs.
Facteurs qui influencent la précision de l’OCR
L'OCR n'est pas un processus binaire de passage ou d'échec. La précision de la sortie dépend de plusieurs facteurs, et la compréhension de ceux-ci vous aide à établir des attentes réalistes et à prendre des mesures pour améliorer les résultats.
Résolution du scan (DPI)
Le DPI (points par pouce) est le facteur le plus important. Une résolution plus élevée signifie plus de données pixel pour que le moteur OCR fonctionne avec.
| DPI | Qualité | Qualités de la OCR |
|---|---|---|
| 72-100 | Résolution de l'écran | Faible — les caractères sont flous, taux d'erreur élevé |
| 150 | Imprimé de faible qualité | Marginal — peut fonctionner pour les grandes polices, peu fiable pour le petit texte |
| 200 | Qualité standard du télécopieur | Acceptable pour les documents propres, lutte avec l'impression fine |
| 300 | Qualité standard du scan | Bon — minimum recommandé pour OCR |
| 600 | Scan de haute qualité | Excellent — la meilleure précision, les plus grandes tailles de fichiers |
Les Guides de conservation numérique de la Bibliothèque du Congrès recommander 300 DPI comme minimum pour le traitement du OCR.
État du document et du scan
Les défauts physiques influent directement sur la précision de l'OCR : les plis et les plis à travers le texte, les taches de café, l'encre fondue (commune dans les relevés imprimées à point-matrice) et le papier jaunâtre réduisent tous la qualité de reconnaissance. Le processus de numérisation ajoute ses propres défis: l'alignement biaisé, les ombres des livrets liés, l'éclairage inégal dans les prises de téléphone, et le flou du mouvement.
Police et mise en page
Les polices serif standard et sans-serif (Times New Roman, Arial) sont reconnues avec une grande précision. Les relevés de compte bancaires exigent également la reconnaissance de la structure de la table — le moteur OCR doit identifier les limites des colonnes, associer les valeurs aux colonnes correctes et distinguer les lignes de transaction des en-têtes et des sous-totals.
Outils OCR pour convertir les relevés bancaires
Trois catégories d'outils OCR sont disponibles, chacune présentant des caractéristiques différentes. (Pour une comparaison plus large des outils de conversion au-delà de l'OCR, voir ce qui est un convertisseur de relevés de compte bancaire.)
OCR Open-Source: Tesseract
Tisseract est le moteur OCR open-source le plus utilisé. Développé à l'origine par HP dans les années 1980 puis maintenu par Google, Tesseract 5 utilise un réseau neuronal LSTM pour la reconnaissance des caractères et supporte plus de 100 langues.
Tesseract est gratuit, fonctionne localement et prend en charge de nombreuses langues. Toutefois, elle n'effectue que la reconnaissance des caractères — elle ne comprend pas la structure du document. Vous obtenez la sortie de texte brut, pas les données de table structurées, de sorte que la conversion de cette sortie en un CSV correctement formaté nécessite une programmation supplémentaire. L'exactitude sur les scans dégradés est inférieure aux solutions de rechange commerciales. Tesseract est un bon choix pour les développeurs qui construisent un pipeline personnalisé, mais ce n'est pas une solution prête à l'emploi pour les comptables.
Services de OCR basés sur le cloud
Les services Cloud OCR traitent les documents sur des serveurs distants et retournent des résultats structurés. Les principales options sont les suivantes: API de Google Cloud Vision (détection de texte avec analyse de la mise en page, ~1,50 $ par 1 000 pages), Amazon Textract (extraction de tableaux et de formulaires structurés, ~15$ par 1 000 pages pour les tableaux), Renseignements sur les documents de Microsoft Azure AI (modèles pré-construits pour les documents financiers avec formation sur mesure disponible).
Les services Cloud OCR offrent une grande précision (surtout sur les documents difficiles), la reconnaissance de la structure de la table intégrée et des améliorations continues du modèle. Les compromis : les données de votre relevé de compte bancaire sont transmises à des serveurs tiers, les prix par page s'additionnent pour une utilisation régulière, et les politiques de conservation des données varient selon le fournisseur.
OCR exécutée sur l’appareil
Sur l'appareil OCR exécute le moteur de reconnaissance localement sur votre ordinateur. Aucune donnée n'est transmise aux serveurs externes.
LocalExtract utilise PP-OCRv5 (PaddlePaddle OCR version 5) ONNX Runtime pour l'OCR à l'appareil. PP-OCRv5 est développé par l'équipe PaddlePaddlePaddle de Baidu et est l'un des modèles d'OCR open-source les plus précis disponibles, avec de solides performances sur le texte anglais et multilingue. ONNX Runtime permet au modèle de fonctionner efficacement sur les processeurs standard sans nécessiter de GPU.
Lorsque vous ouvrez une relevé numérisée dans LocalExtract, l'application détecte le contenu basé sur l'image, exécute le pipeline OCR et sort un fichier CSV — les mêmes formats que vous obtenez à partir d'un PDF basé sur le texte. Sur l'appareil OCR évite l’envoi de scans vers un fournisseur de conversion et n'entraîne pas de frais d'API par page. La sécurité des appareils est toujours importante, et les services de compte et d'abonnement peuvent nécessiter un accès à Internet. Les compromis: la précision peut être inférieure aux services cloud sur les documents difficiles, et les mises à jour du modèle nécessitent des mises à jour de l'application.
Convertir un relevé scanné en CSV : étape par étape
Voici le flux de travail général pour convertir un relevé de compte bancaire numérisé en CSV, quel que soit l'outil que vous utilisez.
Étape 1 : évaluer la qualité du scan
Ouvrez le PDF et zoomez jusqu'à 100%. Si le texte n'est pas précis et lisible à vos yeux, le moteur OCR se débattra aussi. Vérifiez si les données de transaction sont biaisées, ombres et taches. Si la qualité de l'analyse est médiocre et que vous avez le document papier original, le re-scannage à 300 DPI produira de meilleurs résultats que le traitement d'une analyse de faible qualité.
Étape 2 : Exécuter l'OCR
- Tesseract (ligne de commandement):
tesseract statement-page.png output --oem 1 -l eng pdfproduit un PDF consultable, mais vous aurez besoin d'outils supplémentaires pour analyser le texte au format CSV. - OCR nuageux (API): Téléchargez le document via l'API du fournisseur. Des services comme AWS Textratt retournent des données de table structurées qui peuvent être cartographiées en colonnes CSV.
- LocalExtract (application de bureautique) : Ouvrez le PDF numérisé dans l'application. Il détecte automatiquement le contenu basé sur l'image, exécute le PP-OCRv5 OCR et extrait les transactions. Exporter en tant que CSV.
Si votre PDF est basé sur le texte plutôt que scanné, le processus est plus simple -- voir notre guide sur Comment convertir les PDF de relevé de compte bancaire en CSV pour ce flux de travail.
Étape 3 : examiner et vérifier
Avant de faire confiance aux données du CSV, examiner la sortie pour les erreurs courantes du OCR : confusion des caractères (0 vs O, 5 vs S, 8 vs B), les montants fusionnés ou fractionnés, les erreurs de date et les opérations manquantes. Ensuite, vérifiez par rapport à l'original — comparez les comptes de transactions, les montants par rapport aux totaux des relevés et vérifiez les soldes d'ouverture/fermeture.
Étape 4: Corriger les erreurs et exporter
Corriger les erreurs OCR, puis formater le CSV pour votre logiciel de comptabilité: vérifier le format de date (MM/JJ/AAAA pour QuickBooks), supprimer les symboles de monnaie et des milliers de séparateurs, et s'assurer que l'ordre de colonne correspond à ce que votre logiciel attend.
Bonnes pratiques de numérisation pour une meilleure OCR
Si vous contrôlez le processus de numérisation — scanner les relevés sur papier vous-même ou conseiller les clients sur la façon de numériser — ces pratiques amélioreront significativement l'exactitude du OCR.
Résolution : Numériser à 300 DPI minimumC'est vrai. Si l'énoncé a de petites polices (lignes communes de détails de transaction), 400-600 DPI améliorera la précision.
Emplacement: Placez la page à plat et directement sur le lit du scanner. Même une fausseté de 2-3 degrés force le moteur OCR à effectuer le deskewing, qui peut introduire des artefacts. Si vous scannez à partir d'un livret relié, appuyez sur le plat de fixation pour éviter les ombres de la colonne vertébrale.
Mode couleur : Grayscale est le meilleur équilibre de la qualité et de la taille du fichier. Il préserve le contraste texte-arrière-plan sans le survol des données de couleur. Noir et blanc (1-bit) peut fonctionner pour nettoyer les originaux, mais détruit l'information tonale qui aide avec le texte dégradé.
Numérisation de la caméra téléphonique : Utilisez une application de numérisation dédiée (Microsoft Lens, Adobe Scan, Apple Notes) plutôt que l'appareil photo standard -- ces applications appliquent la correction de perspective et le réglage du contraste automatiquement. Placez le document sur une surface plate et bien éclairée et maintenez le téléphone directement au-dessus. Pour un aperçu complet de la conversion des relevés papier en formats numériques (y compris CSV et Excel), voir notre guide sur Comment convertir les PDF de relevé de compte bancaire en CSV.
Pourquoi la vérification n'est pas négociable
Sur un scanner propre, 300 DPI, les moteurs modernes OCR peuvent atteindre 95-99% de précision au niveau des caractères. Cette fourchette est basée sur des critères publiés: Le PP-OCRv4 de PaddleOCR fait état d'une précision de 78,8% sur les ensembles de données Scène Textes difficiles (avec une amélioration de PP-OCRv5) Tesseract obtient 95-99% sur des documents imprimés propres dans des conditions contrôléesC'est vrai. Mais une seule page de relevé de compte peut contenir 2 000 caractères. A 99 % de précision, c'est-à-dire 20 caractères mal reconnus. Il n'y a pas de vérification orthographique des nombres -- 1,500.00 et 1,800.00 sont tous deux des montants valides, donc une lecture erronée 5 comme 8 est indétectable sans données de référence.
Traiter les extrants du OCR comme une ébauche qui doit être revue, et non comme un produit final.
Considérations relatives à la confidentialité des documents numérisés
Les relevés de comptes bancaires numérisés méritent une attention accrue en matière de confidentialité par rapport aux PDF générés numériquement. Une relevé photocopiée peut comprendre des notes manuscrites, des signatures, des timbres et même des documents adjacents (formulaires fiscaux, copies d'identité) si les pages ont été scannées par lots. Une copie numérisée peut comprendre une photocopie de la signature du titulaire du compte ou un numéro de sécurité sociale manuscrit dans la marge.
Lorsque vous téléchargez une relevé numérisée sur un service cloud OCR, tout ce contenu — et pas seulement les données de transaction — est transmis aux serveurs du fournisseur. Le moteur OCR traite toute l'image, et le service peut conserver le document conformément à sa politique de conservation des données. Les FTC Safeguards Rule exige des professionnels financiers qu'ils mettent en place des mesures de protection raisonnables pour l'information des clients. Le traitement des documents via les services cloud n'est pas interdit, mais il crée des obligations de traitement des données que le traitement sur les appareils évite totalement.
Les outils OCR sur l'appareil traitent localement l'image numérisée. Le document, l'analyse du OCR et les données extraites restent tous sur votre ordinateur. Il n'y a pas de transmission réseau et aucun tiers n'a accès au contenu.
Limites de LocalExtract
LocalExtract gère de nombreux scénarios de relevés de compte scannés, mais ce n'est pas le bon outil pour toutes les situations :
- La précision du OCR varie en fonction de la qualité de l'analyse. Sur les scans dégradés (faible résolution, masse d'équerre, encre fondue), les baisses de précision et les services de OCR en nuage avec des modèles plus grands peuvent fonctionner mieux.
- Le texte manuscrit n'est pas pris en charge. Les entrées manuscrites seront ignorées ou ne produiront pas de sortie fiable.
- Toutes les configurations bancaires ne sont pas prises en charge. LocalExtract couvre de nombreuses banques américaines, mais pas tous les formats. Les mises en page non prises en charge peuvent extraire partiellement ou avec des erreurs de structure.
- Pas de sortie QBO ou IIF. Seul le CSV est pris en charge. Les workflows QBO ou IIF nécessitent un outil différent.
- Plus lentement sur les documents numérisés. Le traitement OCR prend plus de temps que l'extraction de texte à partir de PDF numériques, et la vitesse dépend de votre matériel.
Perspectives de l’OCR pour les documents scannés
La technologie du OCR continue de progresser rapidement. De grands modèles linguistiques sont appliqués pour documenter les tâches, ce qui permet aux moteurs de la OCR d'utiliser le raisonnement contextuel -- reconnaissant qu'un chiffre dans une colonne «Montant» est plus probable 5 inférieure à S, ou qu'un champ de date devrait suivre un format spécifique. Les modèles multimodaux qui traitent simultanément l'information visuelle et textuelle montrent des résultats prometteurs dans les repères universitaires, et ces progrès devraient atteindre les outils de production OCR au cours des prochaines années.
Pour les comptables et les comptables, l'incidence pratique est que l'exactitude de la OCR sur les relevés de compte scannés continuera de s'améliorer, et l'écart entre le cloud et la OCR sur les appareils se rétrécira à mesure que des modèles plus petits et plus efficaces seront disponibles. Toutefois, la vérification demeurera essentielle dans un avenir prévisible - les données financières exigent un niveau de précision qu'aucun moteur OCR ne peut garantir sans examen humain.
Conclusion
La conversion des relevés de comptes bancaires numérisés en CSV exige que le OCR soit une étape intermédiaire, et cette étape introduit des considérations d'exactitude qui n'existent pas avec les PDF générés numériquement. La qualité de vos résultats dépend de la résolution de l'analyse, de l'état des documents et du moteur OCR que vous choisissez. Les outils open-source comme Tesseract offrent une flexibilité pour les développeurs, les services cloud fournissent la plus grande précision sur les documents difficiles, et les solutions sur les appareils comme LocalExtract priorisent la confidentialité en gardant tout traitement local. Quelle que soit l'approche que vous utilisez, vérifiez toujours la sortie OCR par rapport à la relevé originale avant d'importer des données dans votre logiciel de comptabilité. De meilleures pratiques de numérisation à la source -- 300 DPI, placement plat, mode à échelle grise -- demeurent le moyen le plus efficace de réduire les erreurs en aval.
Questions fréquentes
Comment puis-je savoir si mon relevé de compte en banque PDF est scanné ou texte? Ouvrez le PDF et essayez de sélectionner du texte avec votre curseur. Si vous pouvez mettre en évidence des mots individuels et les copier, le PDF est basé sur le texte. Si cliquer et glisser ne sélectionne rien ou sélectionne la page entière en tant qu'image, le PDF est scanné et nécessite OCR.
À quelle résolution DPI faut-il numériser les relevés pour l’OCR ? 300 DPI minimum. Pour les relevés avec un petit texte de transaction, 400-600 DPI améliore la précision. Plus de 600 DPI produisent des rendements décroissants.
La sortie OCR est-elle suffisamment précise pour être utilisée sans vérification? C'est pas vrai. Même les meilleurs moteurs OCR font des erreurs, et les données financières ont une tolérance zéro pour les erreurs au niveau des caractères. Vérifiez toujours par rapport à l'original — au minimum, comparez le nombre de transactions et le total des colonnes.
Puis-je numériser les relevés avec mon téléphone pour l’OCR ? Oui, mais utilisez une application de numérisation dédiée (Microsoft Lens, Adobe Scan ou Apple Notes) plutôt que l'appareil photo standard. Ces applications appliquent automatiquement la correction de perspective et l'amélioration du contraste. Les scanners de téléphone fonctionnent pour des documents propres, mais produisent une qualité inférieure à celle d'un scanner à plat.
Quelle est la différence entre les services Tesseract et Cloud OCR ? Tesseract est libre et fonctionne localement mais affiche du texte brut sans structure de document — vous devez l'analyser dans une table vous-même. Les services Cloud (AWS Textratt, Google Vision) offrent une plus grande précision et une extraction structurée de la table, mais nécessitent l’envoi de documents vers des serveurs tiers et des frais par page.
Est-ce que LocalExtract nécessite une connexion Internet pour OCR? C'est pas vrai. LocalExtract exécute PP-OCRv5 via ONNX Runtime entièrement sur votre appareil. Le modèle OCR est livré avec l'application, de sorte qu'aucune connexion Internet n'est nécessaire pendant le traitement.
Combien coûte LocalExtract? offre gratuite limitée: 10 pages (vie). Plan pro : 10 $/mois ou 60 $/année, sans limite de page; traiter un PDF à la fois. Les deux niveaux traitent les fichiers entièrement sur votre appareil.
L'OCR peut-il gérer les relevés de compte bancaires dans des langues autres que l'anglais? PP-OCRv5 prend en charge plusieurs langues pour la reconnaissance des caractères. Cependant, la logique d'analyse des états de compte bancaires de LocalExtract est actuellement axée sur les états de compte bancaires américains de langue anglaise. Le moteur OCR peut reconnaître des caractères dans d'autres langues, mais l'extraction structurée peut ne pas fonctionner correctement pour les formats non américains.
Transparence : cet article est publié par l’équipe LocalExtract, qui développe le convertisseur de bureau et a un intérêt commercial dans ce sujet. Comparez les lignes exportées à votre propre relevé. Les guides bancaires et les captures d’écran générales ne garantissent pas la compatibilité.
Tesseract lit des images, pas des PDF en entrée. Convertissez d’abord une page en PNG ou utilisez OCRmyPDF pour traiter un PDF. Voir la documentation officielle des formats d’entrée, vérifiée le 11 octobre 2026.
LocalExtract Team
Nous développons LocalExtract, un convertisseur de relevés pour ordinateur. Questions ou corrections ? Contact · Politique éditoriale